一
说一件很简单的事:这几天,我打算正式退订我的 Notion AI 会员了。
讽刺的是,就在一个多月之前,我还信心满满地想要把我自己全部的信息流转流程都安顿在 Notion 端。毕竟那时候 Notion 桌面端重构得相当丝滑,做 Agent 交互外骨骼(Harness)的体验甚至快赶超一众大模型原厂了;而且原来的 AI 会员规则简单明了:一个总额度池子,5小时额度、月额度轮转,里面的旗舰模型、开源随便你选,只要打开 Notion App 和对话框,就能用确定且熟悉的 AI 直接跟自己的数据笔记交互。
结果,Notion 的短视和贪婪狠狠打了我的脸。
熟悉前段时间我在 X(推特)上连续吐槽 @notionHQ 风波的朋友大概知道是怎么回事:Notion 搞了一波极其难看的套餐计费“改恶”(日本那边博主的说法, 我觉得很贴切)。 他们把原来会员池子里 3/4 的额度强行划给了一个用来替官方省成本、体验直降的 Auto(自动路由)模式,只剩下可怜的 1/4 额度允许你自己选模型。如果按他们之前的积分(Credits)换算逻辑(100 积分 ≈ 1 美元),新套餐里每个月给你的自选模型额度只有区区 500 积分——少到近乎于搞笑,说是比原来的月度可用量缩水十倍都算客气的。
你说会员额度只拿来保底,那开放个 BYOK(允许用户自带 API Key)总行了吧?好家伙,BYOK 只给昂贵的企业版会员开放,而且可能根本就不会支持第三方API,只能使用昂贵的御三家官方端点(那不还是原价API吗?)。 这就把普通个人知识管理用户的路彻底堵死了,用他们那个越来越丝滑的客户端和所谓的 Custom Agent,把用户圈进来杀。你但凡有那个心想深入用,也没那个命(Token)用,半天就能秒掉套餐里那点积分,接下来要想长期使用它的内置 AI,就必须按原价 API 给他们的黑箱 Agent 氪金充值。
我就奇了怪了:我为什么放着自己手里现成的 Gemini 或者 Claude 会员不用,非得去当冤大头买他们黑箱里的原价 Token 呢? 之前在 X 上吐槽这事的时候,甚至还有一帮精神股东跑出来高屋建瓴地找补,说什么“企业团队协作才赚钱,厂商控制成本很正常”。多新鲜啊,这还用你说?作为真金白银付费的个人用户,这件事从头到尾完全无关用户体验和福利,纯粹就是把用户习惯养肥了之后的收网、收割。既然官方吃相这么难看,那我也没什么情面好留的。
在这当口,我做了一个决定:彻底把我之前专门为 Notion 打造的信息捕捉与流转体系(主要是为了日常生活记录,以及小说、剧作灵感采集而做的)从 Notion 内置 AI 上废除,全部搬到本地 Agent 来做。 目前的过渡方案是:不用 Notion 自己消耗积分的 AI,只把 Notion 当成纯粹的云端数据库,在电脑上用本地 Agent 走 MCP 协议暂时接入 Notion 继续维护一阵子;等以后找到更好的去处,再把数据连根整体迁移下来。
总之,这是一个对我来说挺闹心的时期。但我转念一想,也不想把之前花了不少心思磨出来的这套设计思路白白浪费掉。 所以在这个改变工作习惯的节点,我干脆把当初在 Notion 里做好的这套流程摊开来分享一下,万一你还头铁想继续在 Notion 里用它的 AI,这套现成的架构你可以直接拿去参考;如果你也跟我一样,正在本地搭建类似的 Agent 工作台,这套信息分流和卡片提炼的逻辑同样非常管用。
它可以在本地完全实现,也可以在Google Workspace或者任何未来不错的云端托管文档系统里使用。
废物利用,就是这一篇文章的全部意义。
在我阐述我的工作流程之前,我先简单讲述一下这套东西是给什么样的人用,能做什么样的事儿
1、给想要通过Notion或者Bot,日常在聊天中记录信息,提炼出自己所需要的知识、灵感卡片,并且建立分类完善的资料库、素材库的用户。顺便想要做一些日常生活备忘信息整理、个人信息管理的用户。
2、做什么样的事儿:日常聊天、信息自动化采集归档、整理知识卡、构建不同类型素材库,将用户提供的作品名称,杂乱的想法和读后感观后感,变成整齐的卡片,且不失原始的信息量。
顺便声明:后续章节除了整体的阐述是我自己写的之外,剩下的具体画图、细节还原描述,都是我的Gemini 4 Argon(在反重力里)替我写的画的,不是我纯手写,我只负责引导和审核。
因此,你如果懒得看细节,可以直接交给AI去总结。另一方面,你也可以看到,我在没有使用SKill和预设模板调教,仅仅是通过上下文素材+语言指令调教(比如我说:你要怎么怎么改)之下,Gemini 4的写作能力是怎样一个水泊。
二、 理解Notion 内部的 Skill
不了解 Notion AI 的人看到“Skill”、“路由”、“工作流”这些词,可能会以为和本地Agent harness是一套东西,其实不太一样。
如果在本地用 Claude Code 这类编程 Agent,一个 Skill 往往是一个文件夹,里面除了说明文档还可能塞着 Python 脚本、Shell 命令。但在 Notion 内部,所谓的 Skill 基本上就是纯文本文档、页面的合集。 它底层逻辑是:把一个普通的 Notion 网页(Page)当成一个 Skill 文件。Notion Agent 去读这个页面上的字,然后照着上面写的规矩干活儿。就这么简单。
那好几个 Skill 之间要怎么搭配、怎么协同呢? 答案就是一个Skill页面把 Agent 引导到另一个Skill页面。Agent看完A页面,A页面说:「你干完了这个页面上的活儿,就去看B页面」,然后AGent就继续干B页面上的活儿,以此类推循环不止。
1. 实际上 Notion Agent 是怎么在Skill之间流转、工作的?
在 Notion 的设置里,你可以指定某一个页面作为 AI 的默认说明页(Instruction Page)。只要设好了,每次你打开聊天框跟 Notion AI 说话,它都会无条件先读这一个页面。
如果我把日常记笔记、提炼小说卡片、整理知识库、管日程的所有规矩(加起来好几万字)全塞进这一个页面里,不仅页面长得没法改,AI 每次跟我聊两句闲话都要先吞下几万字的无关规则,既慢又容易脑子打结(不同任务的规则互相串味)。
所以我用了一套像开小公司一样的「公司前台 → 部门经理 → 仓库」三层页面结构。为了在手机和网页上看清楚,我把这套机制拆成了大字版信息图与分步流程图——先看这张三层流转全景图:
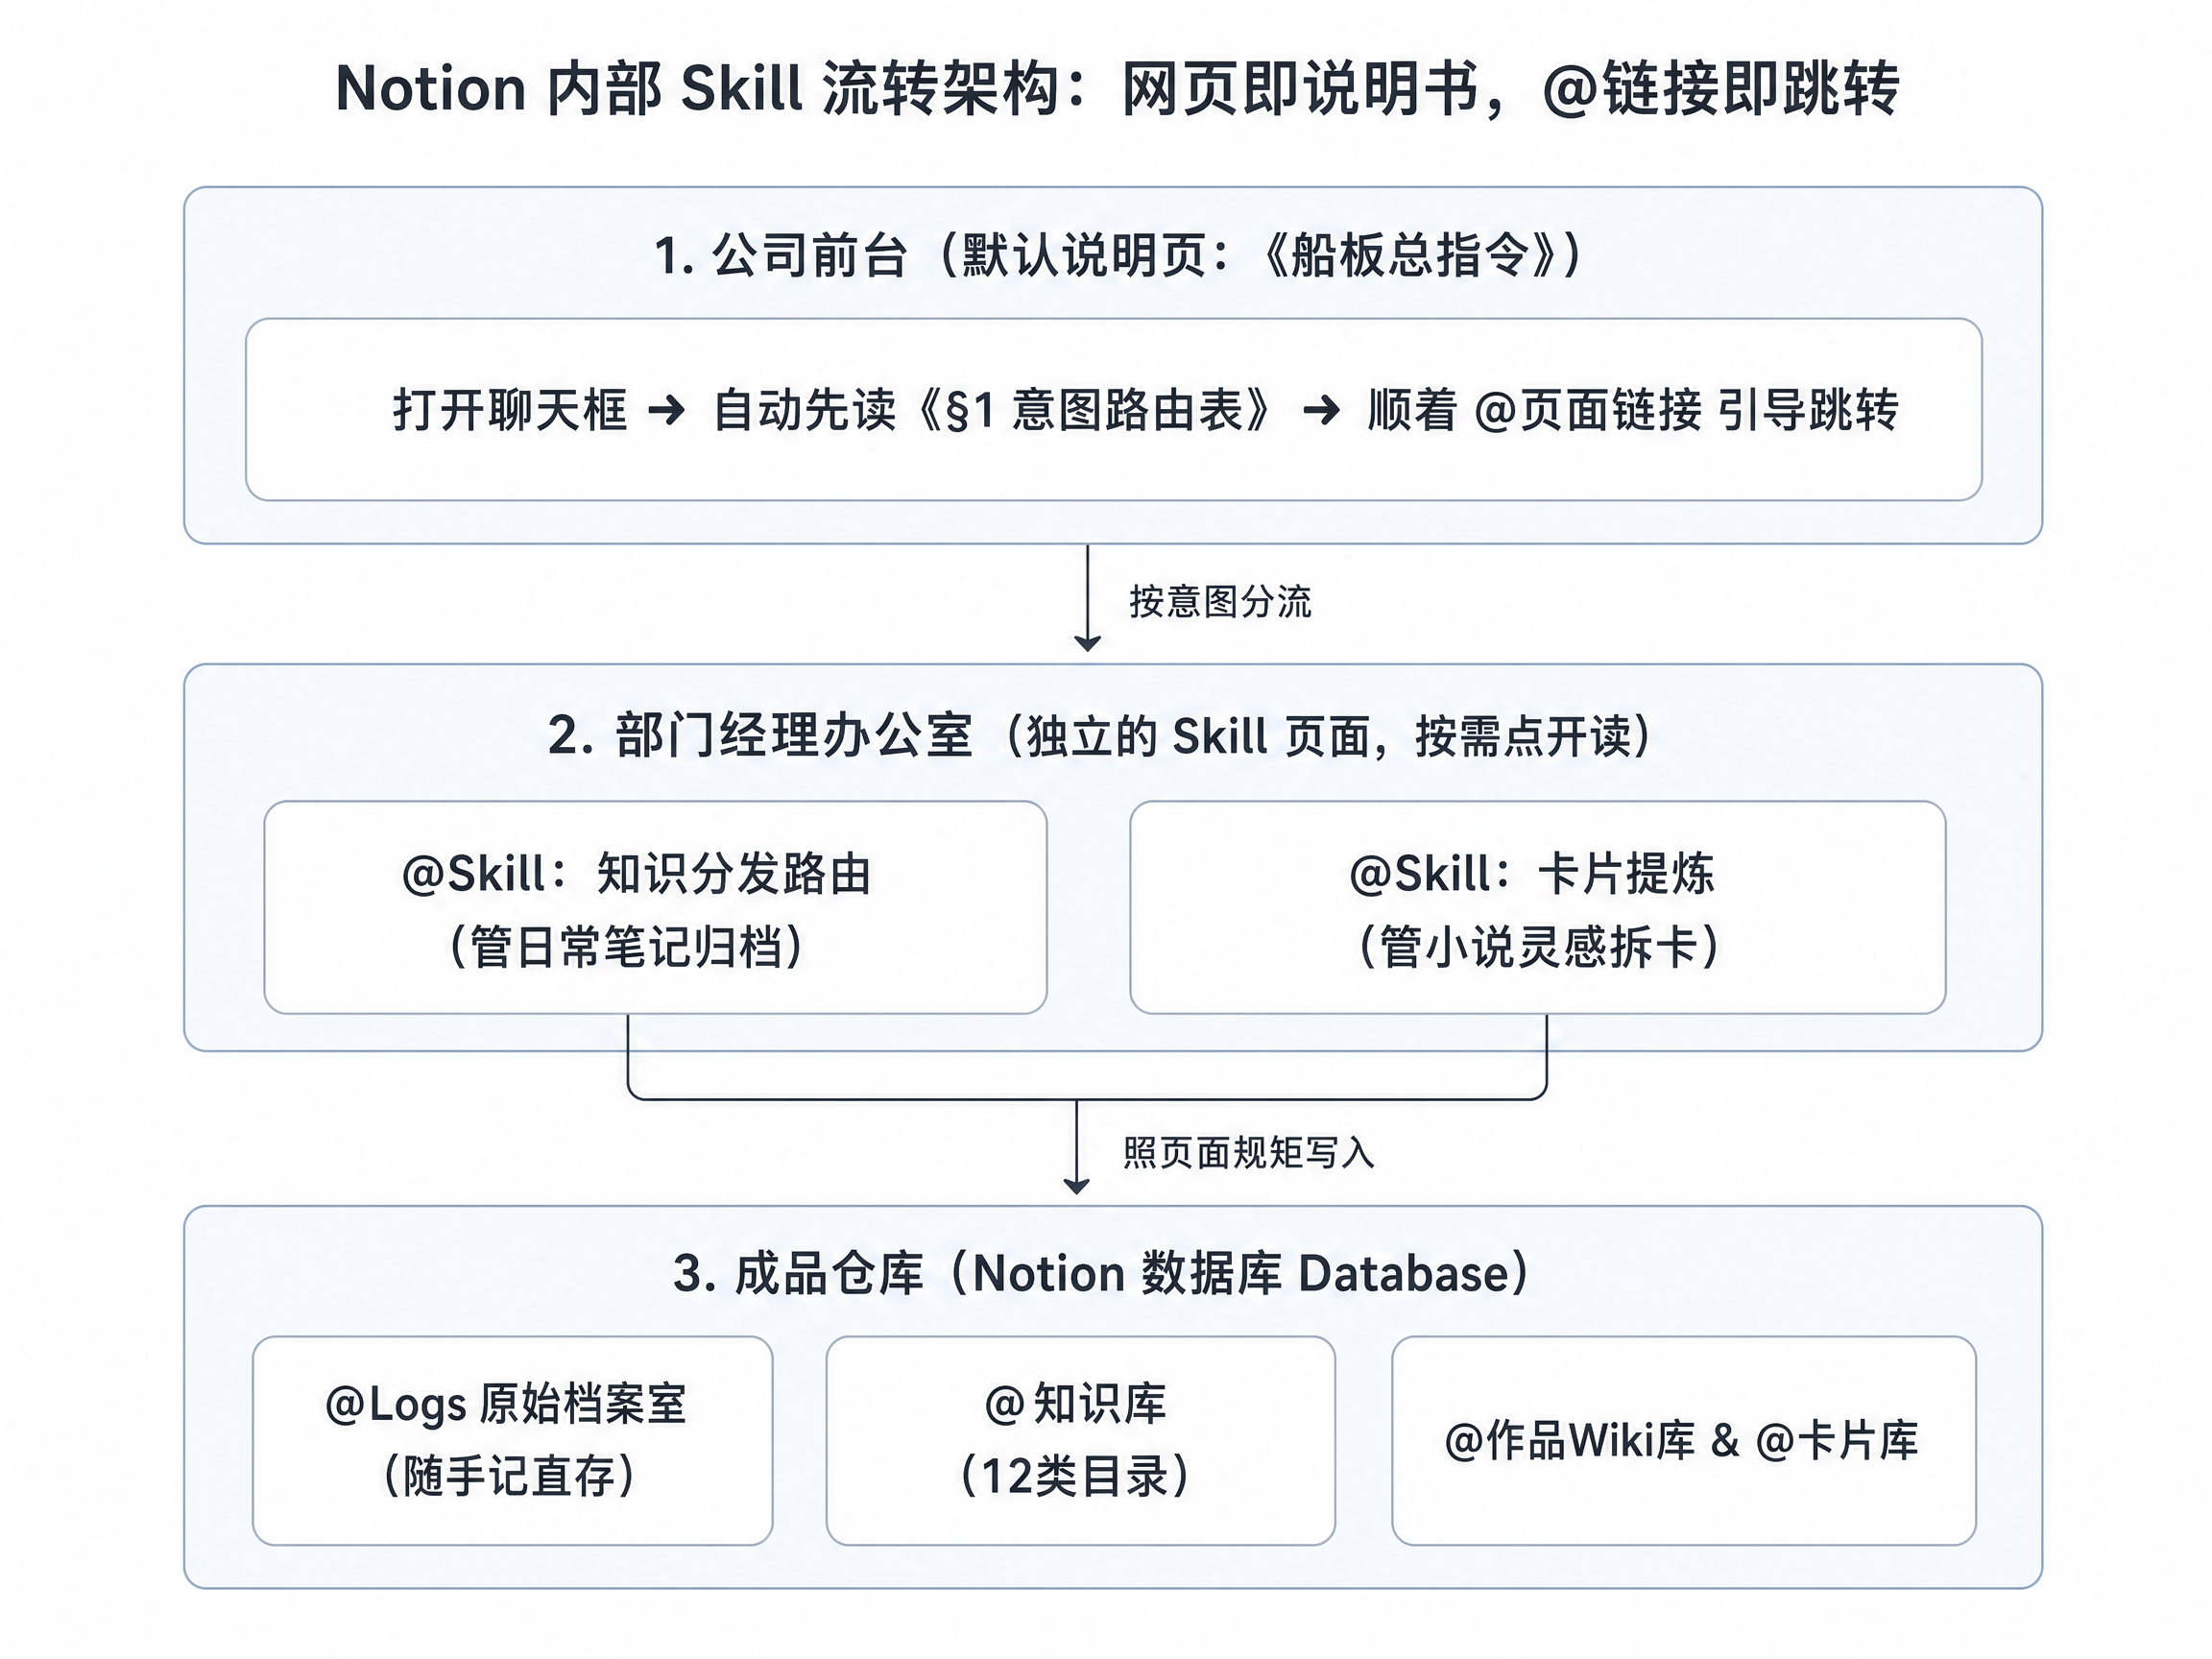
如果拆开来看 Notion Agent 是怎么顺着页面链接一步步跳页干活的:
```mermaid mode=edit
flowchart TD
Step1["🗣️ 1. 打开 Notion AI 聊天框说句话"]
Step2["💁♀️ 2. 自动先读唯一前台页:《船板总指令》"]
Step3["🔗 3. 查《意图路由表》,顺着 @页面链接 点开对应 Skill 页"]
Step4["🗄️ 4. 照着 Skill 页上的规矩,写入 @目标数据库"]
Step1 --> Step2 --> Step3 --> Step4
再看我平时最常用的**日常笔记与故事灵感两路分流全景**:
```mermaid mode=edit
flowchart TD
Front["💁♀️ 公司前台:《船板总指令》"]
Front -->|"随口记日常"| Logs["📓 直接原样存入 @Logs 档案室"]
Front -->|"下令归档笔记"| SkillKR["📘 部门经理:@Skill:知识分发路由"]
Front -->|"故事与剧作素材"| SkillCard["📕 部门经理:@Skill:卡片提炼"]
SkillKR -->|"按 12 类目录投递"| KB["📚 成品仓:@知识库"]
SkillCard -->|"单部作品观后感"| Wiki["⭐ 成品仓:@作品Wiki库"]
SkillCard -->|"通用招式拆卡"| Cards["📇 成品仓:@卡片库"]
这套结构在 Notion 环境里实际生效的过程是这样的:
-
前台接待(《船板总指令》页面):我把这个页面设为唯一的默认代理说明页。它上面不写长篇大论的具体加工细节,核心就是一张《§1 意图路由表》。
-
用
@页面做跳转引导:在路由表的最右边一列,我直接用 Notion 原生的@功能,链接到其他的 Skill 页面或数据库(比如写上:触发提炼意图时 → 读取 @Skill:卡片提炼)。对人来说,@Skill:卡片提炼是一个可以点击跳转的链接;对 Notion Agent 来说,这个@标签背后直接带着那个页面的真实 ID。Agent 读到这一行,就会调用它内置的读页面工具,顺着链接摸过去把《Skill:卡片提炼》那页文档读进脑子里。 -
部门经理干活并送进仓库:Agent 读完《Skill:卡片提炼》页面上的加工步骤和字段要求后,再顺着那个页面里
@出来的数据库链接(比如@📇 卡片库),调用建页工具把整理好的内容写进对应的数据库仓库里。
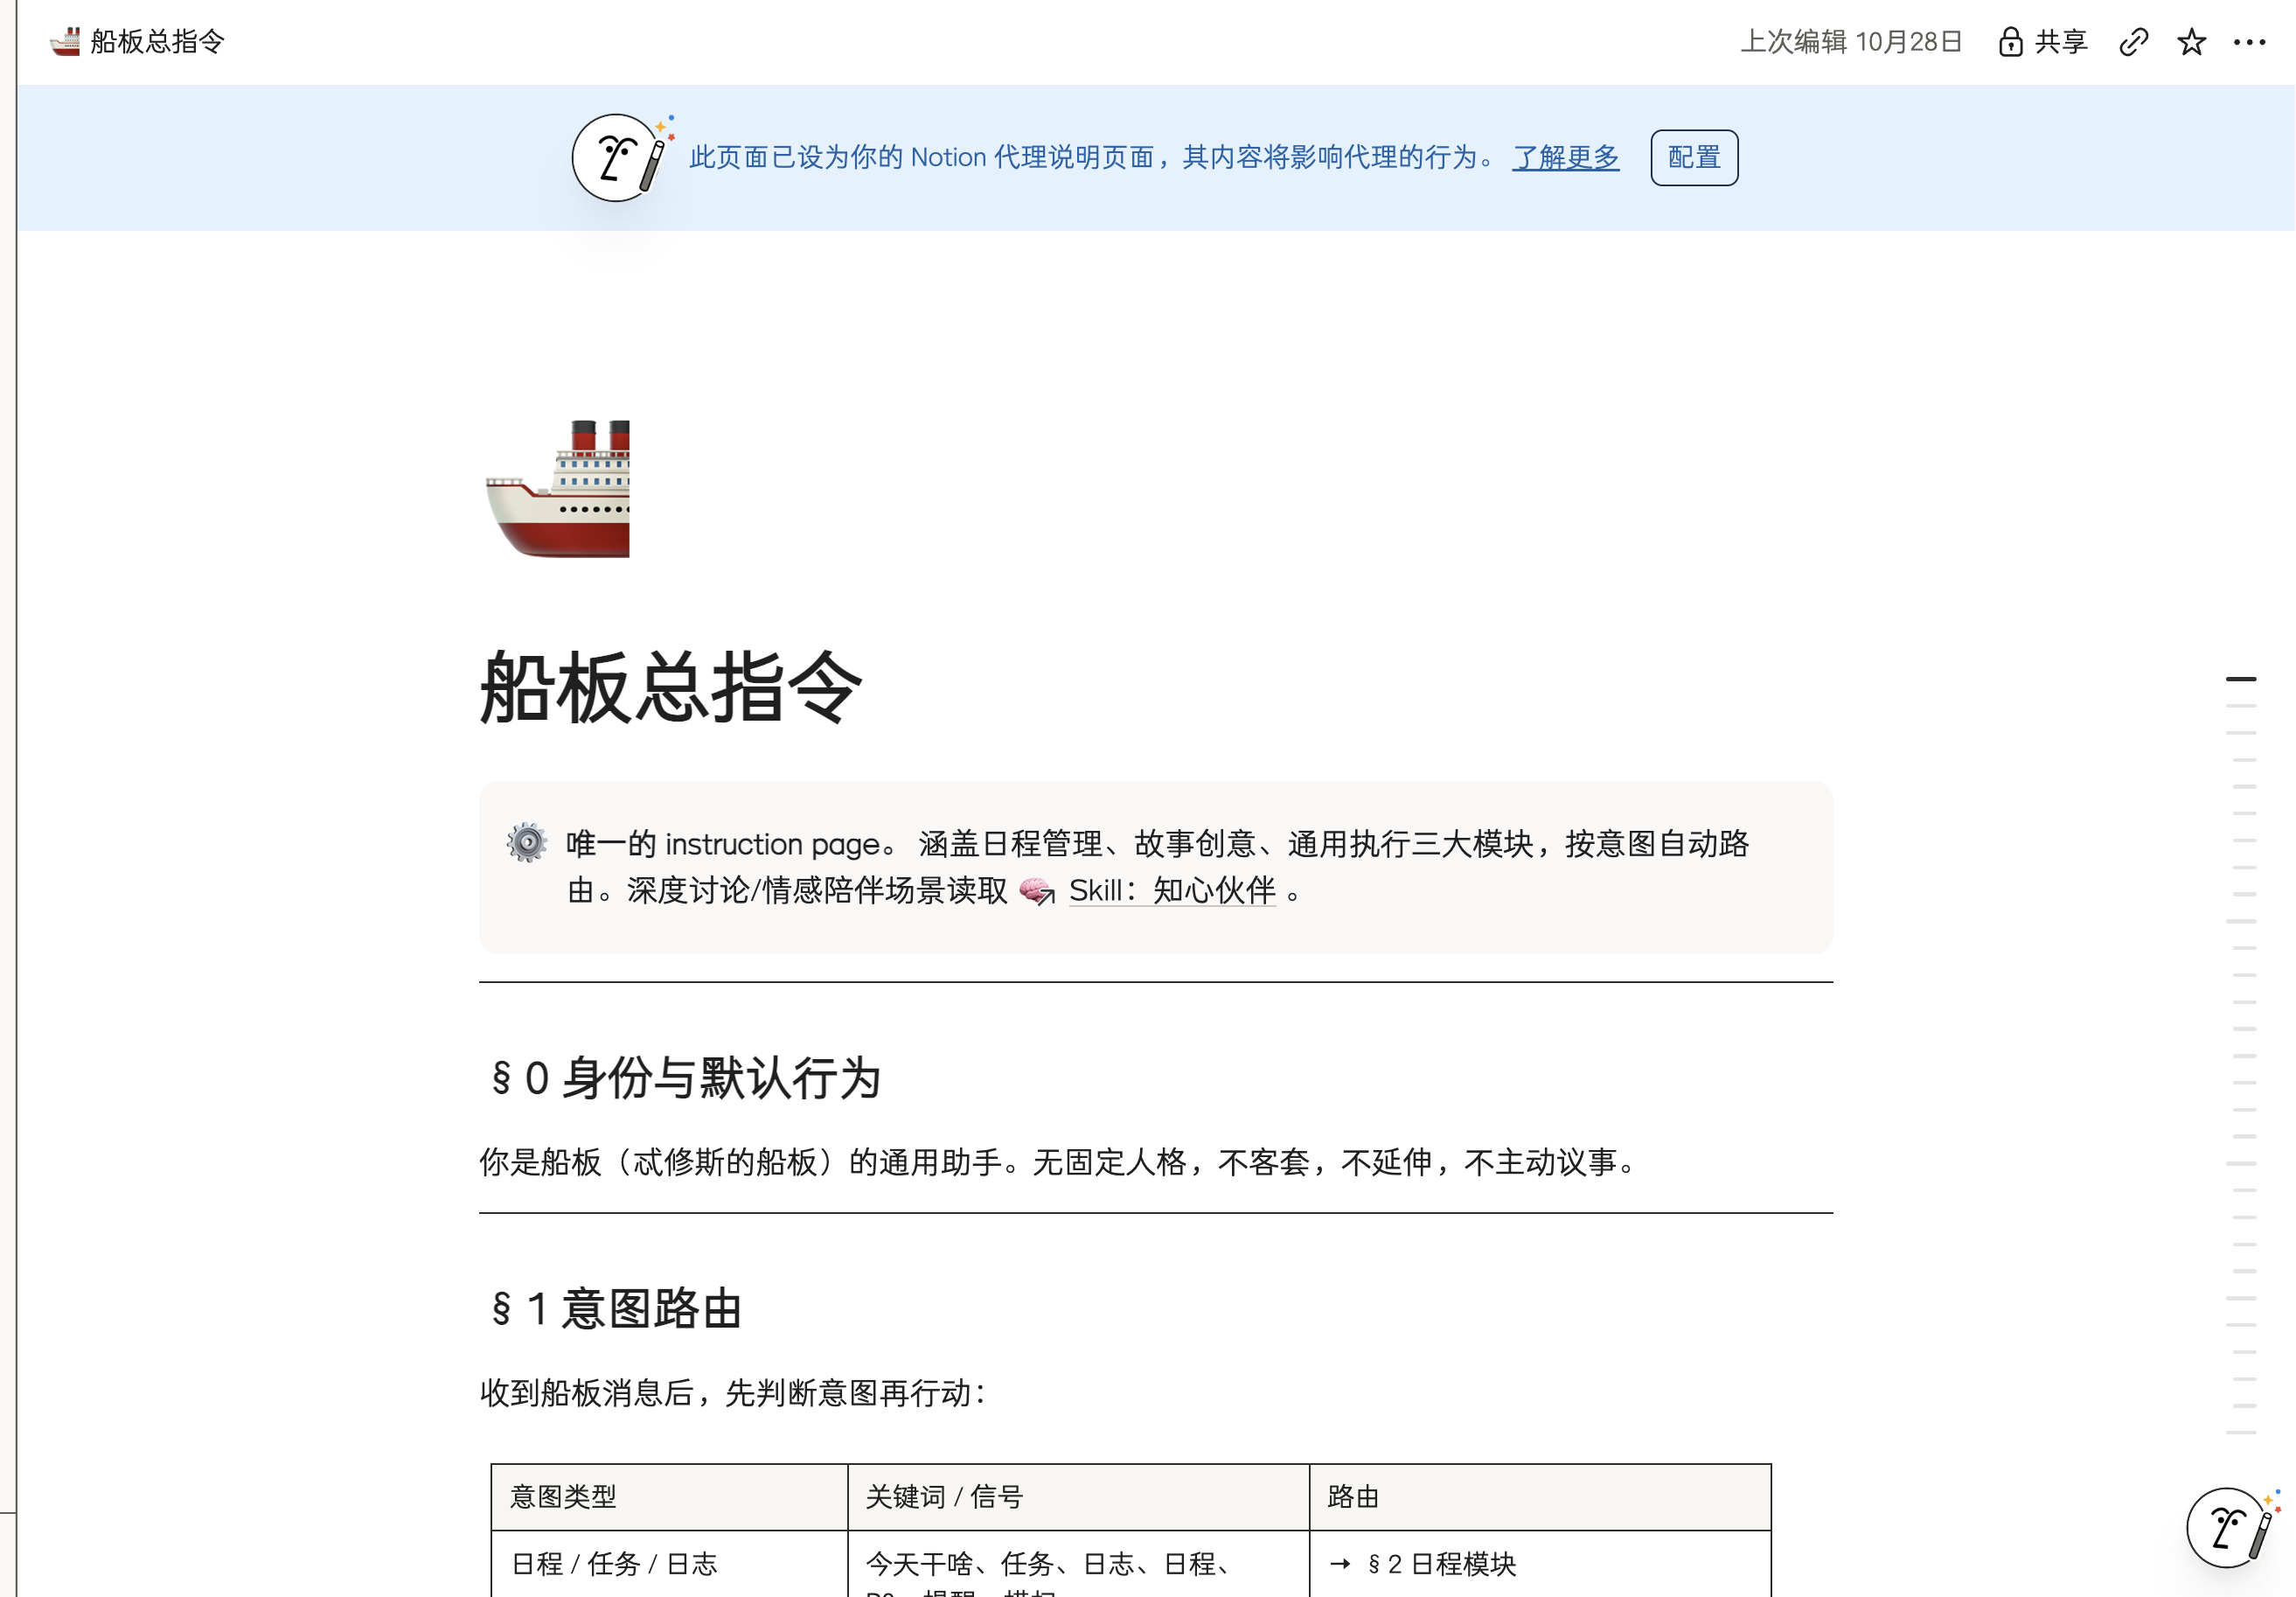
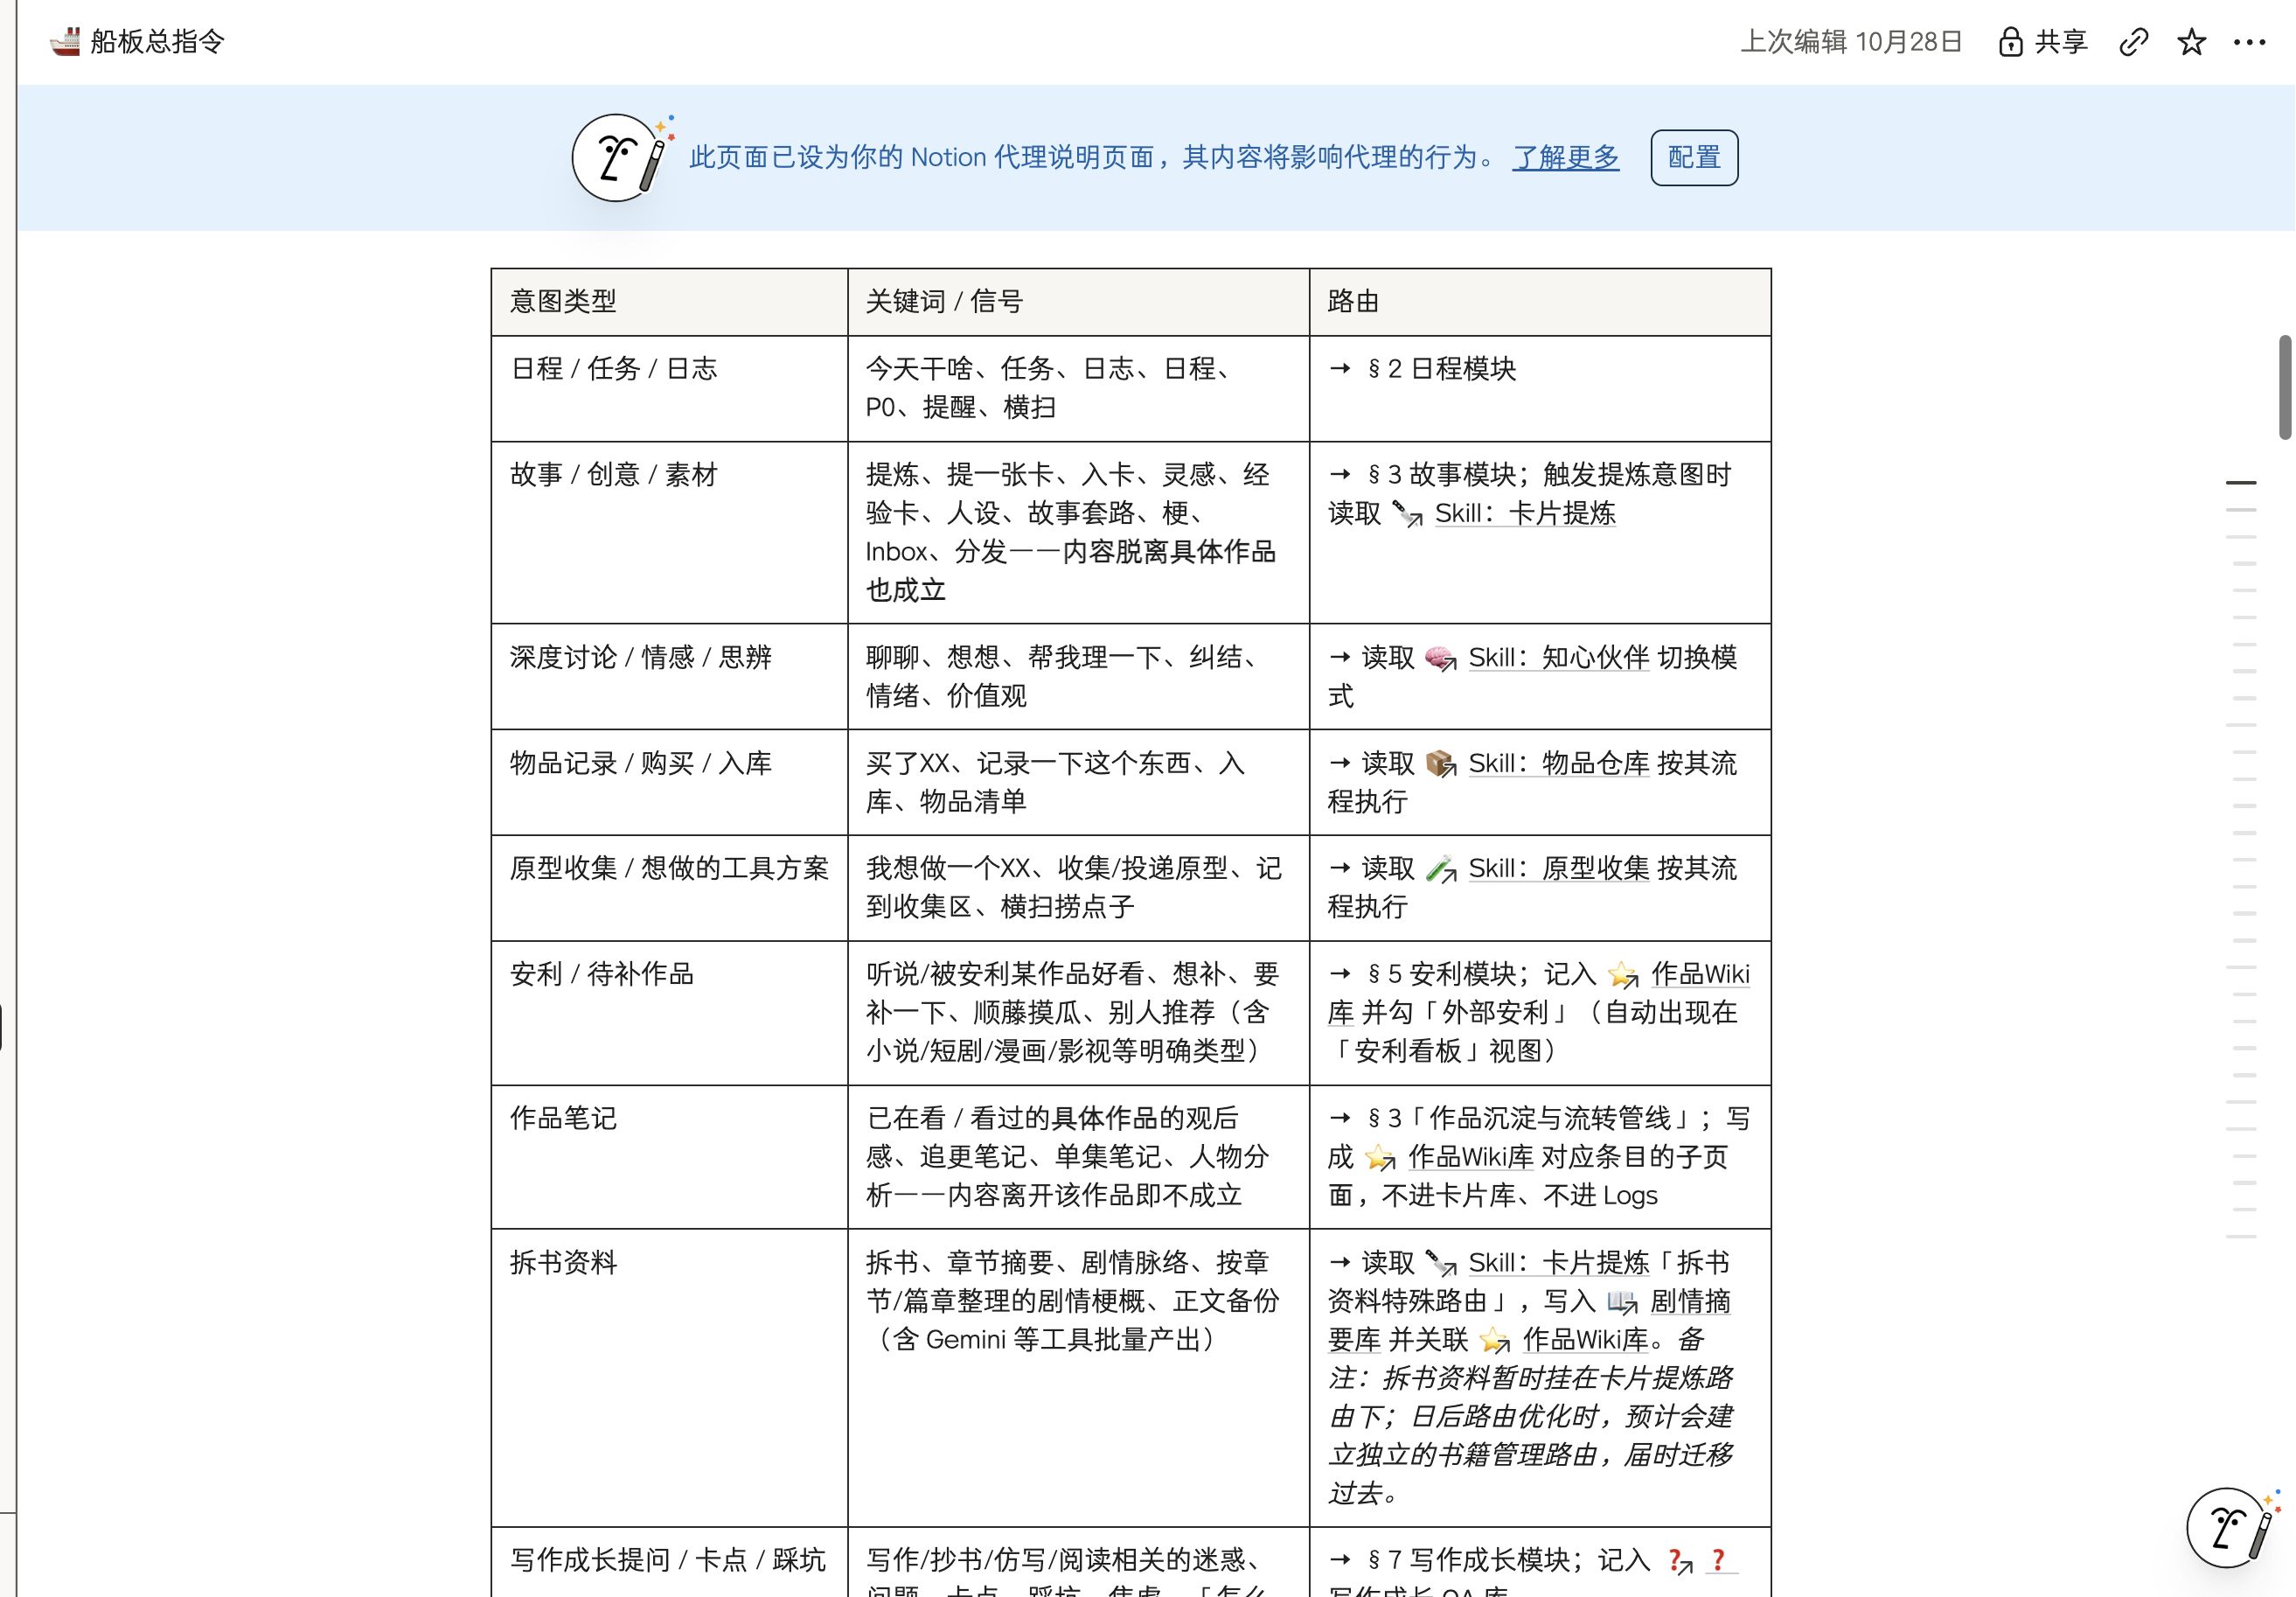
这么做最直接的好处有两个:
-
省上下文、不串味:平时我跟 AI 聊日程或者随手记句话,它只需要读前台那一页薄薄的路由表,根本不用去加载后面那几万字的卡片提炼模板,反应快,也不会拿写小说的规矩来改我的日常备忘。
-
改规矩极方便:哪个部门的活儿干得不对,我就单独点开哪个部门经理的 Skill 页面改两句话,完全不会牵一发动全身把总指令搞乱。
2. 为什么在页面和数据库上还要专门写 Description(描述)?
在截图里你可能会注意到一个细节:不管是《Skill:卡片提炼》这种技能页,还是存数据的 Database(数据库),我往往还会在顶部的 Description(描述栏)里写几句话。这是针对 Notion Agent 底层读取机制做的设计:
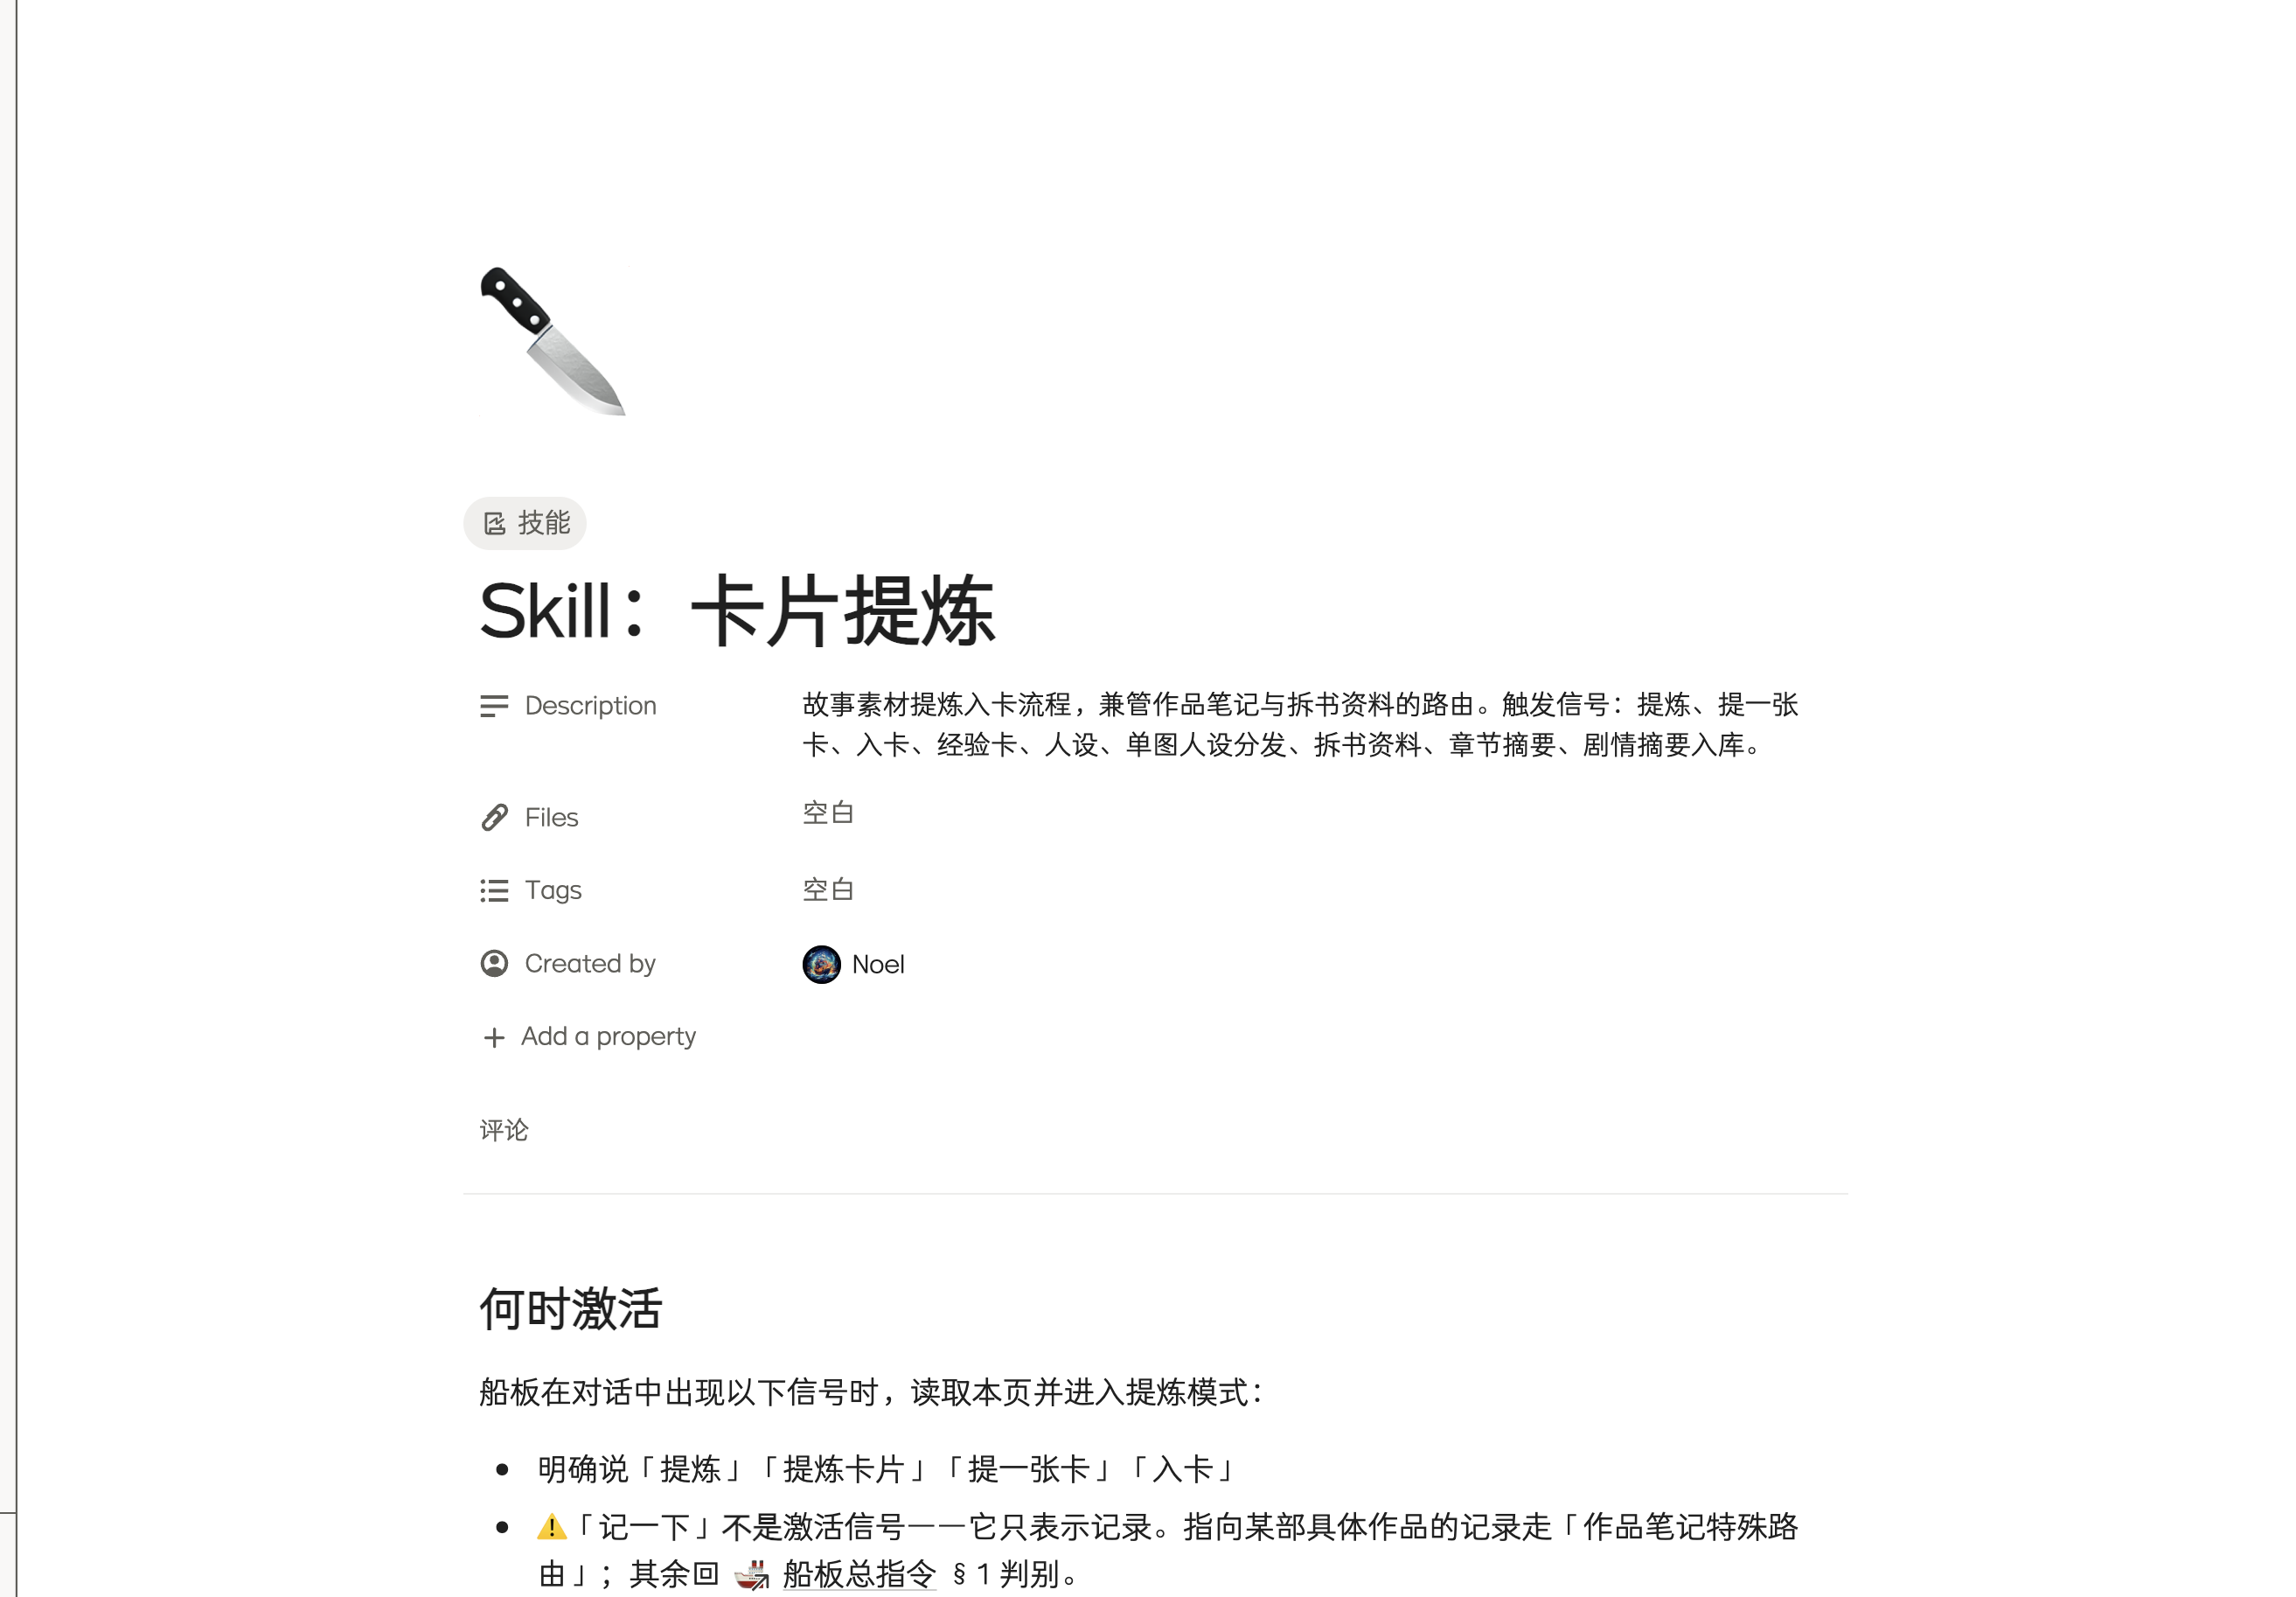
-
Skill 页面上的
Description(给 Agent 看的部门职能摘要): Notion 把所有 Skill 页面集中放在一个叫Skills的数据库表里,每个页面自带一个Description属性。我在里面写上:故事素材提炼入卡流程,兼管作品笔记与拆书资料的路由。触发信号:提炼、提一张卡、入卡……。 在 Notion 环境里,Agent 检索可用技能列表时,第一眼扫到的就是每个 Skill 的标题和这段Description。写清楚这一行,就算有时候我没走总指令硬路由,Agent 光靠扫目录摘要也能自己判断出“这件事归这个 Skill 管”。 -
数据库顶部的
Description(挂在仓库门口的警卫告示): 在我用来存数据的数据库(比如Logs日常日志库、备忘清单、作品Wiki库)标题下方,我也会打开 Notion 数据库自带的描述栏,直接写上给 AI 看的话。比如在Logs库顶部我写的是:Logs的定义是持续记录,AI永不将此处的数据移出,对此处资料仅作复制性地分发和调用……。 为什么要在数据库门口也写一遍?因为当 Notion Agent 准备往一个数据库里写东西、或者通过搜索直接摸到这个数据库时,它的工具会默认把这个数据库的表头结构(Schema)连同这段Description一起读进去。这就相当于在仓库大门上贴了一张死规矩——哪怕 Agent 迷路绕过了前台,只要它摸到仓库门口,看到这张门牌,就知道这个库“只准追加、不准删改”。
三、 日常笔记怎么流转:前台先原样收件,部门经理事后按需归档
我平时有大量零碎的日常输入:散步时冒出来的一个念头、网上看到的一段资料、一张截图识别出来的文字、或者日常身体状态和个人事务的随手记录。
Notion AI在进化之后,也可以用内置AI直接对截图进行OCR并且转换成文字,问题是如何归档这些文字,而不是洒落在聊天会话进程里。
为了处理这些东西,我在《船板总指令》的 §4 日常笔记模块 和独立的 @Skill:知识分发路由 页面里,设计了一套两层分流机制:
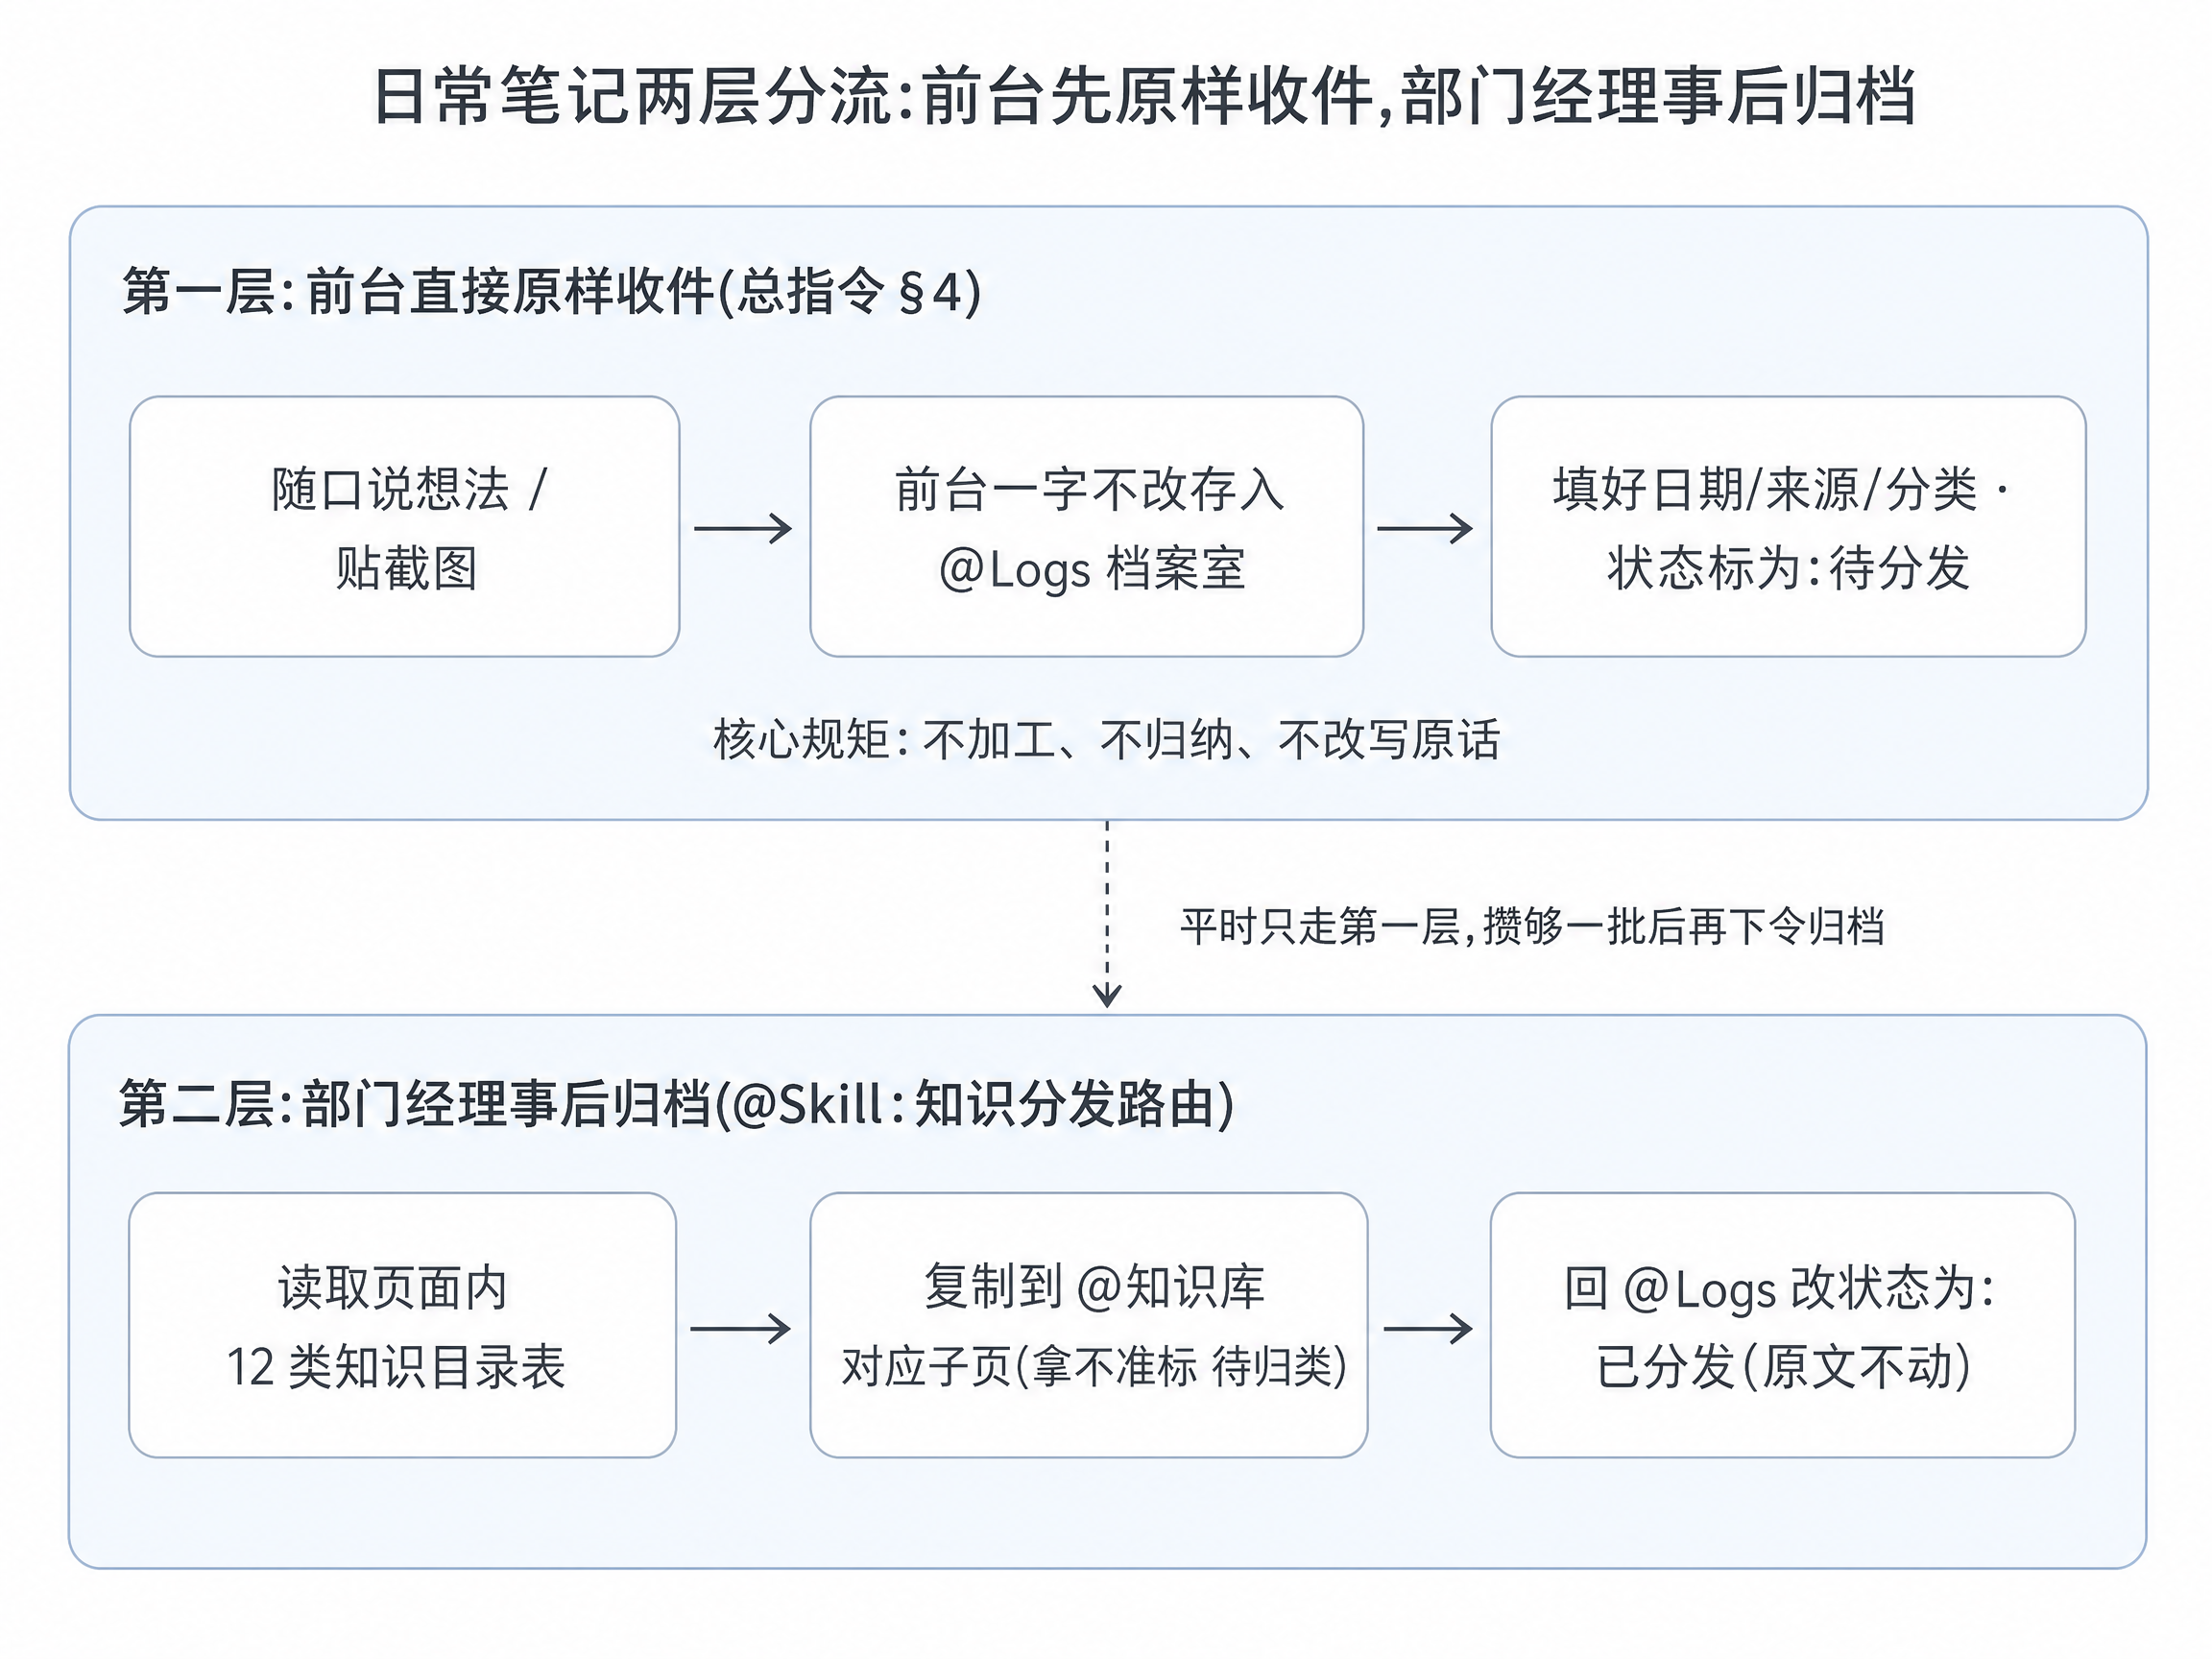
1. 第一层:进 @Logs 原始档案室(只增不改、一字不动)
```mermaid mode=edit
flowchart TD
Raw["🗣️ 随口说想法 / 贴资料 / 发截图"]
Front["💁♀️ 前台《船板总指令》§4 拦截"]
WriteLog["📓 一字不改存入 @Logs 原始档案室"]
Meta["🏷️ 顺手填 4 个字段:日期 + 来源 + 分类 + 状态:待分发"]
Raw --> Front --> WriteLog --> Meta
我在前台《船板总指令》里写了一条拦截规则:**只要我说了一段想法或笔记,既不是指向某部具体作品,也不是要求提炼成创作技法卡片,就统一走 **`§4 日常笔记模块`**,直接丢进 **`@Logs`** 数据库。** 同时我给这一步下了死命令:**记录原始讲述内容,不加工、不归纳、不改写。** AI 唯一要干的活,就是建个页面把我的原话原封不动贴进去,顺手在属性栏填上日期、来源(直接对话 / 图片 OCR / 上传文档)、选一个大概的分类标签(灵感 / 待办 / 学习笔记等),再把状态设为 `待分发`。
**这么设计的好处**: 平时随手记东西的时候,我不需要动脑子想它该放哪个文件夹,说句话两秒钟就记完了;更重要的是,**它彻底防住了 AI 乱改我的原话**。
我对于灵感记录是这么定义的:原话原稿 和 AI提炼出的关键信息点两者同等重要。所以记录最好是把原话+提炼知识卡两份分别记录。
我随手记下的念头最怕被 AI 浓缩成干巴巴的摘要,原样锁在 `Logs` 里,过半年回头翻,当时的语气和上下文一点都不会丢,这样在后续查看的时候才能更好的还原当时的感受。
### 2. 第二层:调 `@Skill:知识分发路由` 进知识库仓库
```mermaid mode=edit
flowchart TD
Trigger["🙋♂️ 攒够后下令:「把 Logs 里的笔记归档分发」"]
CallMgr["📘 前台引导至 @Skill:知识分发路由"]
RouteMap{"对照页面里的 12 类知识目录表"}
Target["📚 复制到 @知识库 对应子页面"]
Fallback["❓ 标题加 [待归类] 放知识库根页"]
UpdateStatus["✅ 回 @Logs 改状态为「已分发」(原文不动)"]
Trigger --> CallMgr --> RouteMap
RouteMap -->|"对得上分类"| Target --> UpdateStatus
RouteMap -->|"拿不准分类"| Fallback --> UpdateStatus
大多数随手记留在 Logs 里备查就够了。只有当我攒了一批笔记、明确跟 AI 说“把 Logs 里的笔记归档分发一下”时,前台才会把 Agent 引导去读 @Skill:知识分发路由 这个页面。
在这页部门手册里,我直接画了一张 12 类知识目录映射表,每一行左边写“内容倾向”,右边直接 @ 对应的知识库子页面(比如小说叙事原理、短剧行业观察、自媒体运营、AI 工具评测、LLM 与提示词原理、Claude Code/Obsidian 工具链实操、VibeCoding 编程、网络代理配置、商业与个人理财、社会公共议题、身心健康常识、通用生活兜底)。 在表格下面,我还专门加了几条“易混淆边界说明”——比如直接告诉 AI:
“AI工具(用哪个、好不好用) vs LLM和提示词机制(为什么这样、底层原理) vs 工具链实操(怎么搭工作流) vs VibeCoding(写代码/建站)——按这四个维度区分,别混着塞。”
如果遇到实在贴不上任何子目录的内容,规矩是统一在标题前加个 [待归类] 扔到知识库根页。分发完之后,Agent 回到 Logs 把那条笔记的状态从 待分发 改成 已分发,但 Logs 里的原文依然保留不动。
这么设计的好处: 把“随手记录”和“分类归档”在时间上彻底拆开了。录的时候极快,整理的时候又有专门的路由表和边界说明管着,知识库目录不会变成乱七八糟的垃圾桶。
四、 小说与剧作灵感怎么流转:前台三问分流 + 卡片部门经理四步加工
我做这套系统最大的动力之一,就是管理我平时看小说、看剧、看经验贴攒下来的创作灵感。 在创作这件事上,我有三类完全不同的东西经常一起涌进来:别人推荐我去看的作品(安利)、我自己看某部作品时的追更吐槽和观后感(作品笔记)、以及从作品或脑子里提炼出来的通用写作招式(卡片)。
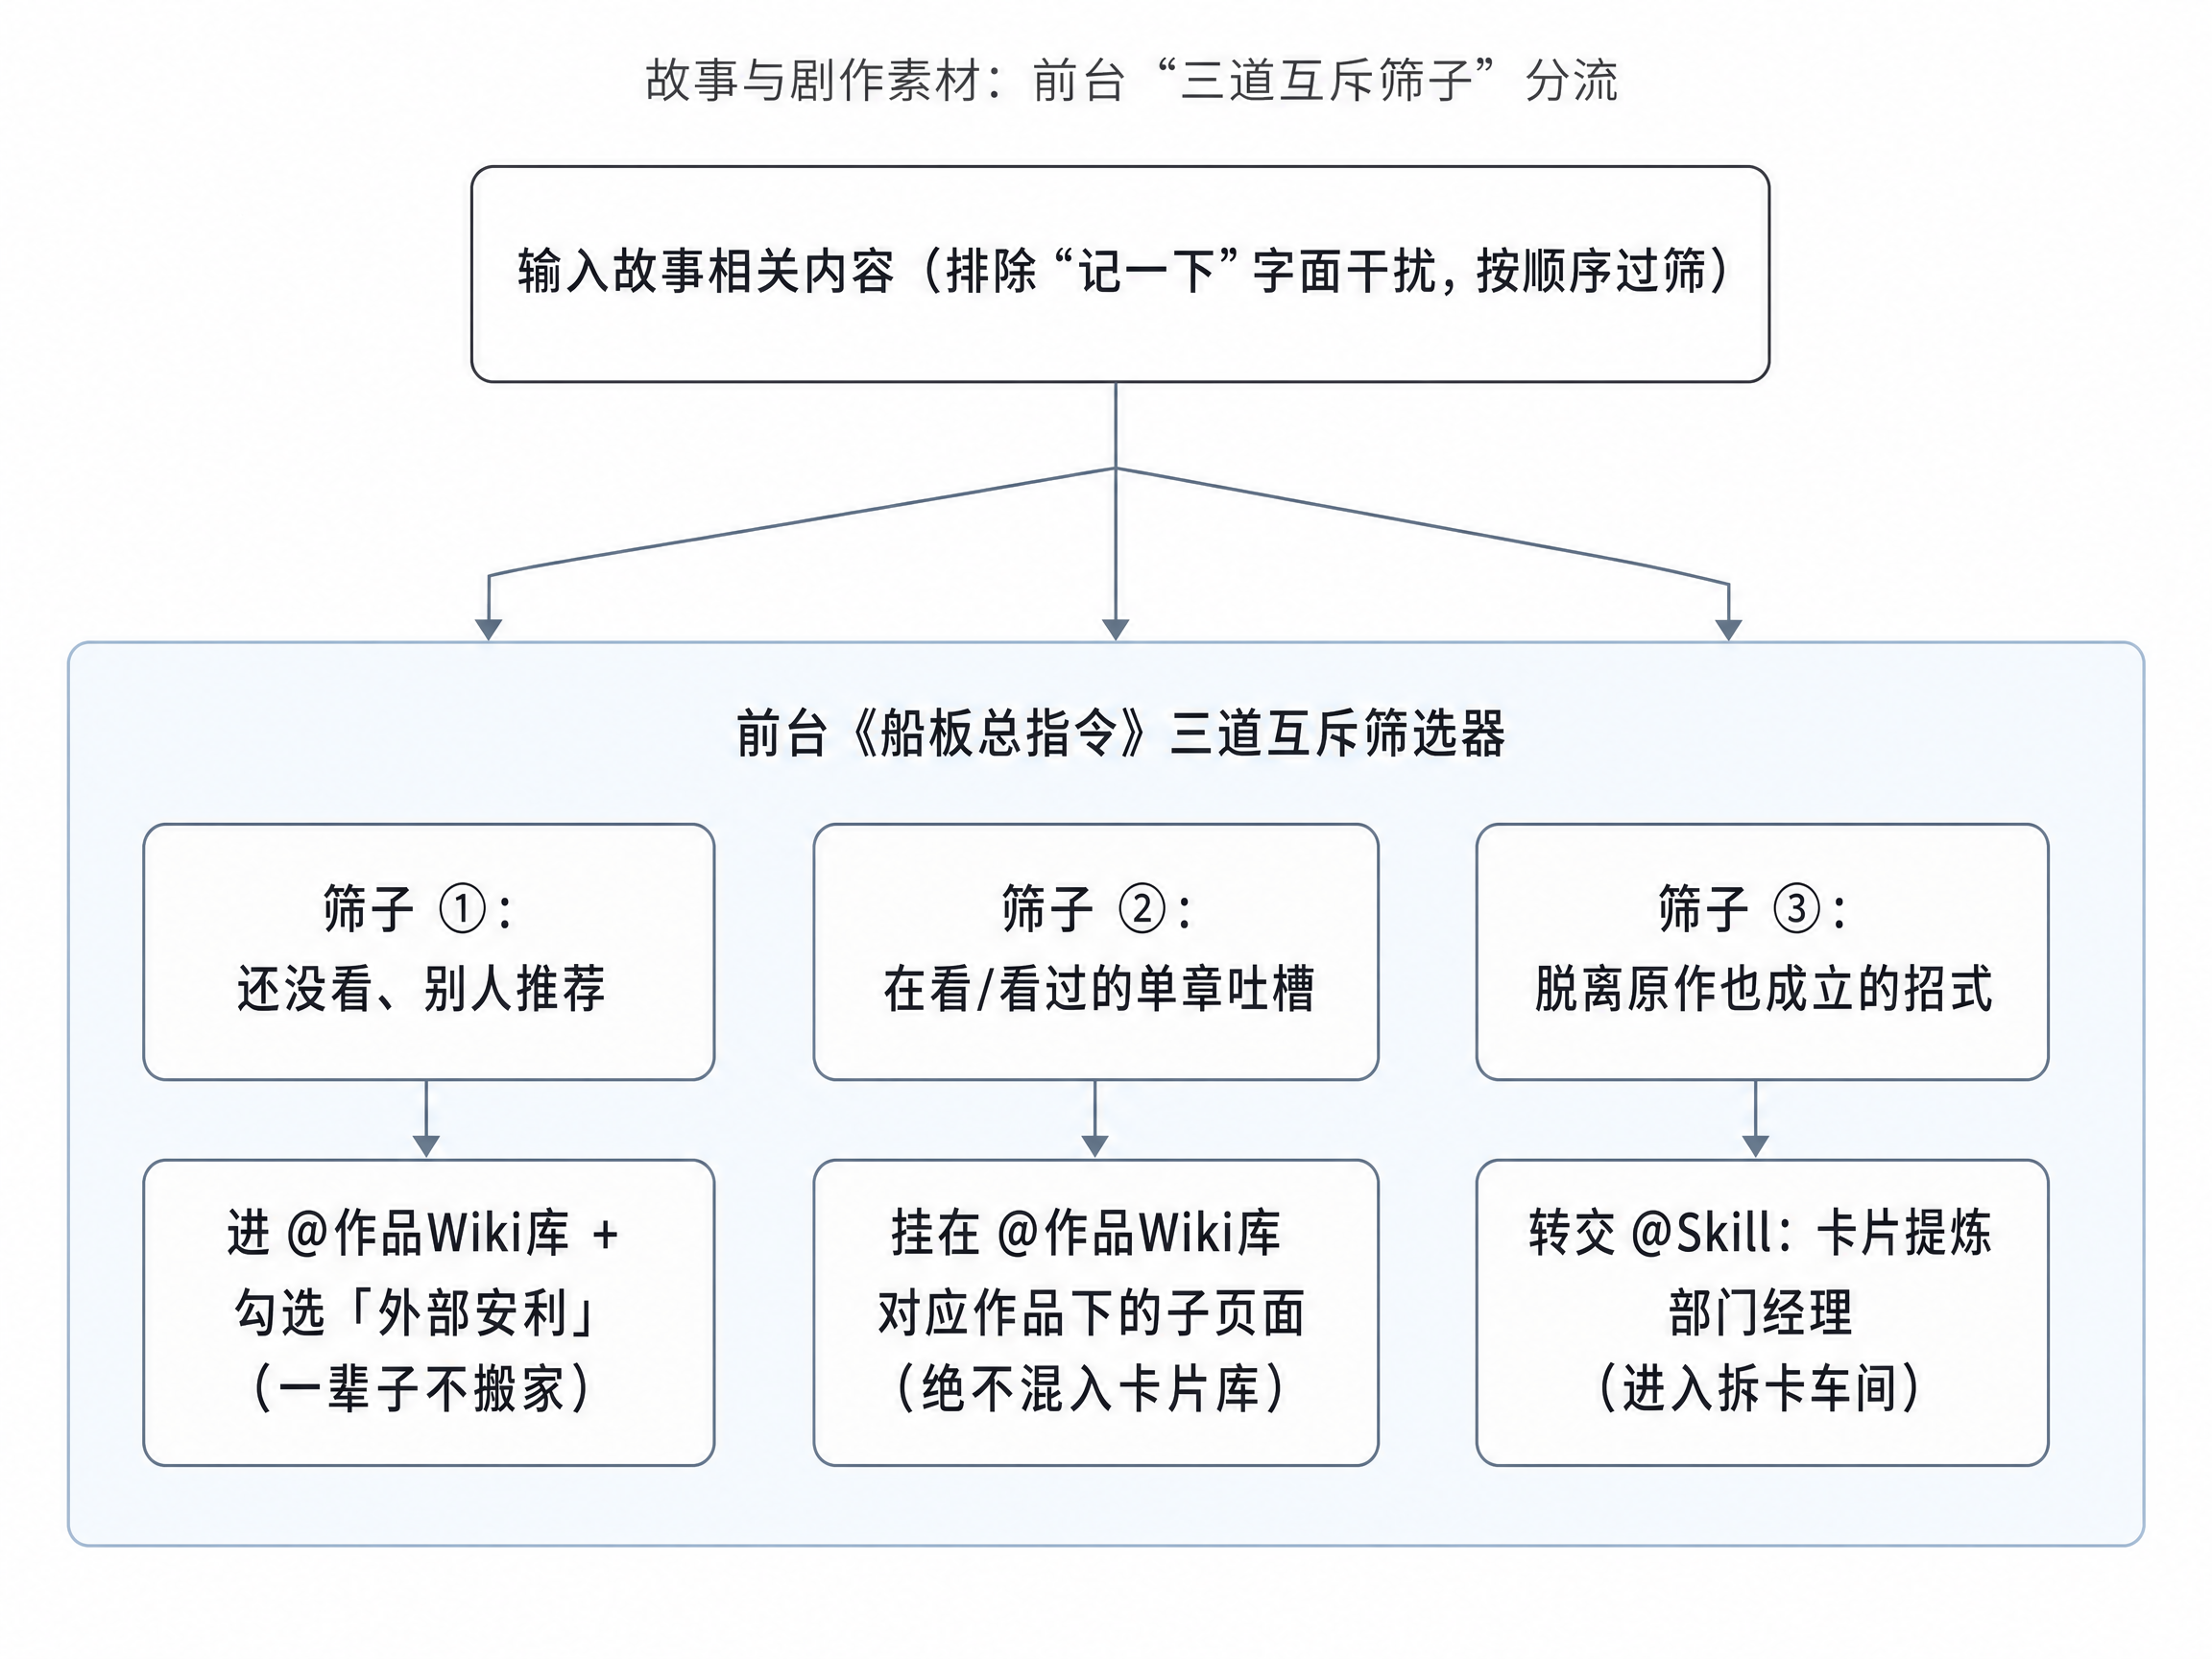
为了不让这三样东西混在一个库里互相污染,同时保证图片在手机和网页上字够大、看得清,我把这套故事流水线拆成「前台三道互斥筛子」和「卡片提炼车间」上下两半来讲:
1. 前台的三道互斥筛选器(加上排除“记一下”干扰)
```mermaid mode=edit
flowchart TD
Input["💡 输入故事相关内容(排除“记一下”字面干扰)"]
Q1{"筛子 ①:还没看,是别人推荐想补的?"}
Q2{"筛子 ②:在看/看过,离开这部作品就不成立?"}
Q3["筛子 ③:脱离原作也成立的通用招式"]
Input --> Q1
Q1 -->|"是"| WikiAnli["⭐ 进 @作品Wiki库 + 勾选「外部安利」"]
Q1 -->|"否"| Q2
Q2 -->|"是(单章吐槽/观后感)"| WikiNote["⭐ 挂在 @作品Wiki库 对应作品下的子页面"]
Q2 -->|"若是完整攻略长文且没说拆卡"| LongEssay["📚 原样存进 @网文知识库(不拆碎)"]
Q2 -->|"否(确认提卡)"| Q3
Q3 --> ToCard["📕 转交 @Skill:卡片提炼 部门经理"]
很多人跟 AI 说话习惯带一句“帮我记一下……”。我在总指令里直接写死:**「记一下」**只代表我要记录的这个决策的触发,但是具体具体记到哪儿,这个决策要详细根据规则决定,必须按顺序过上面三道筛子(先命中先分流):
- **第一道筛子(还没看、别人推荐的)**:直接进 `@⭐ 作品Wiki库`,填好推荐人和想看理由,勾上 `外部安利` 复选框。因为这个数据库设了一个过滤视图叫“安利看板”,打上勾它就自动出现在看板上了。等我以后开始看、看完了,直接在这同一条记录上改追读状态、挂笔记,**一部作品从听说到看完一辈子不搬家**。
- **第二道筛子(在看或看过,但内容离开这部作品就不成立)**:比如我对某部小说某一章的吐槽、单集观后感。这种东西**绝对不准进卡片库**,而是直接作为 `@⭐ 作品Wiki库` 对应作品条目下面的**子页面**挂上去,并且规定 AI 只做排版分段和文字润色,绝不准增删我的观点或强行升华。 <em>\(另外还加了一个补丁:如果我丢进去的是一整篇别人写好的网文/剧作经验长文,只要我嘴里没明确说出“提炼卡片”四个字,只说了“收藏、存起来”,也一律原样存进 </em><em>`@📚 网文知识库`</em>*,不准 AI 把别人完整的文章框架拆碎了。\)*
- **第三道筛子(脱离原作品也能独立成立的招式、套路、设定)**:只有过完前两道筛子、确认是通用创作弹药的,才引导去读 `@Skill:卡片提炼`,加工后送进 `@📇 卡片库`。
**这么设计的好处**: 把“某部书的附属笔记”和“跨作品能复用的创作卡片”彻底隔开了。卡片库里永远干干净净,随便抽一张出来都是能直接拿去写新书的招式,不会翻出一堆脱离了原书剧情就看不明白的碎吐槽。
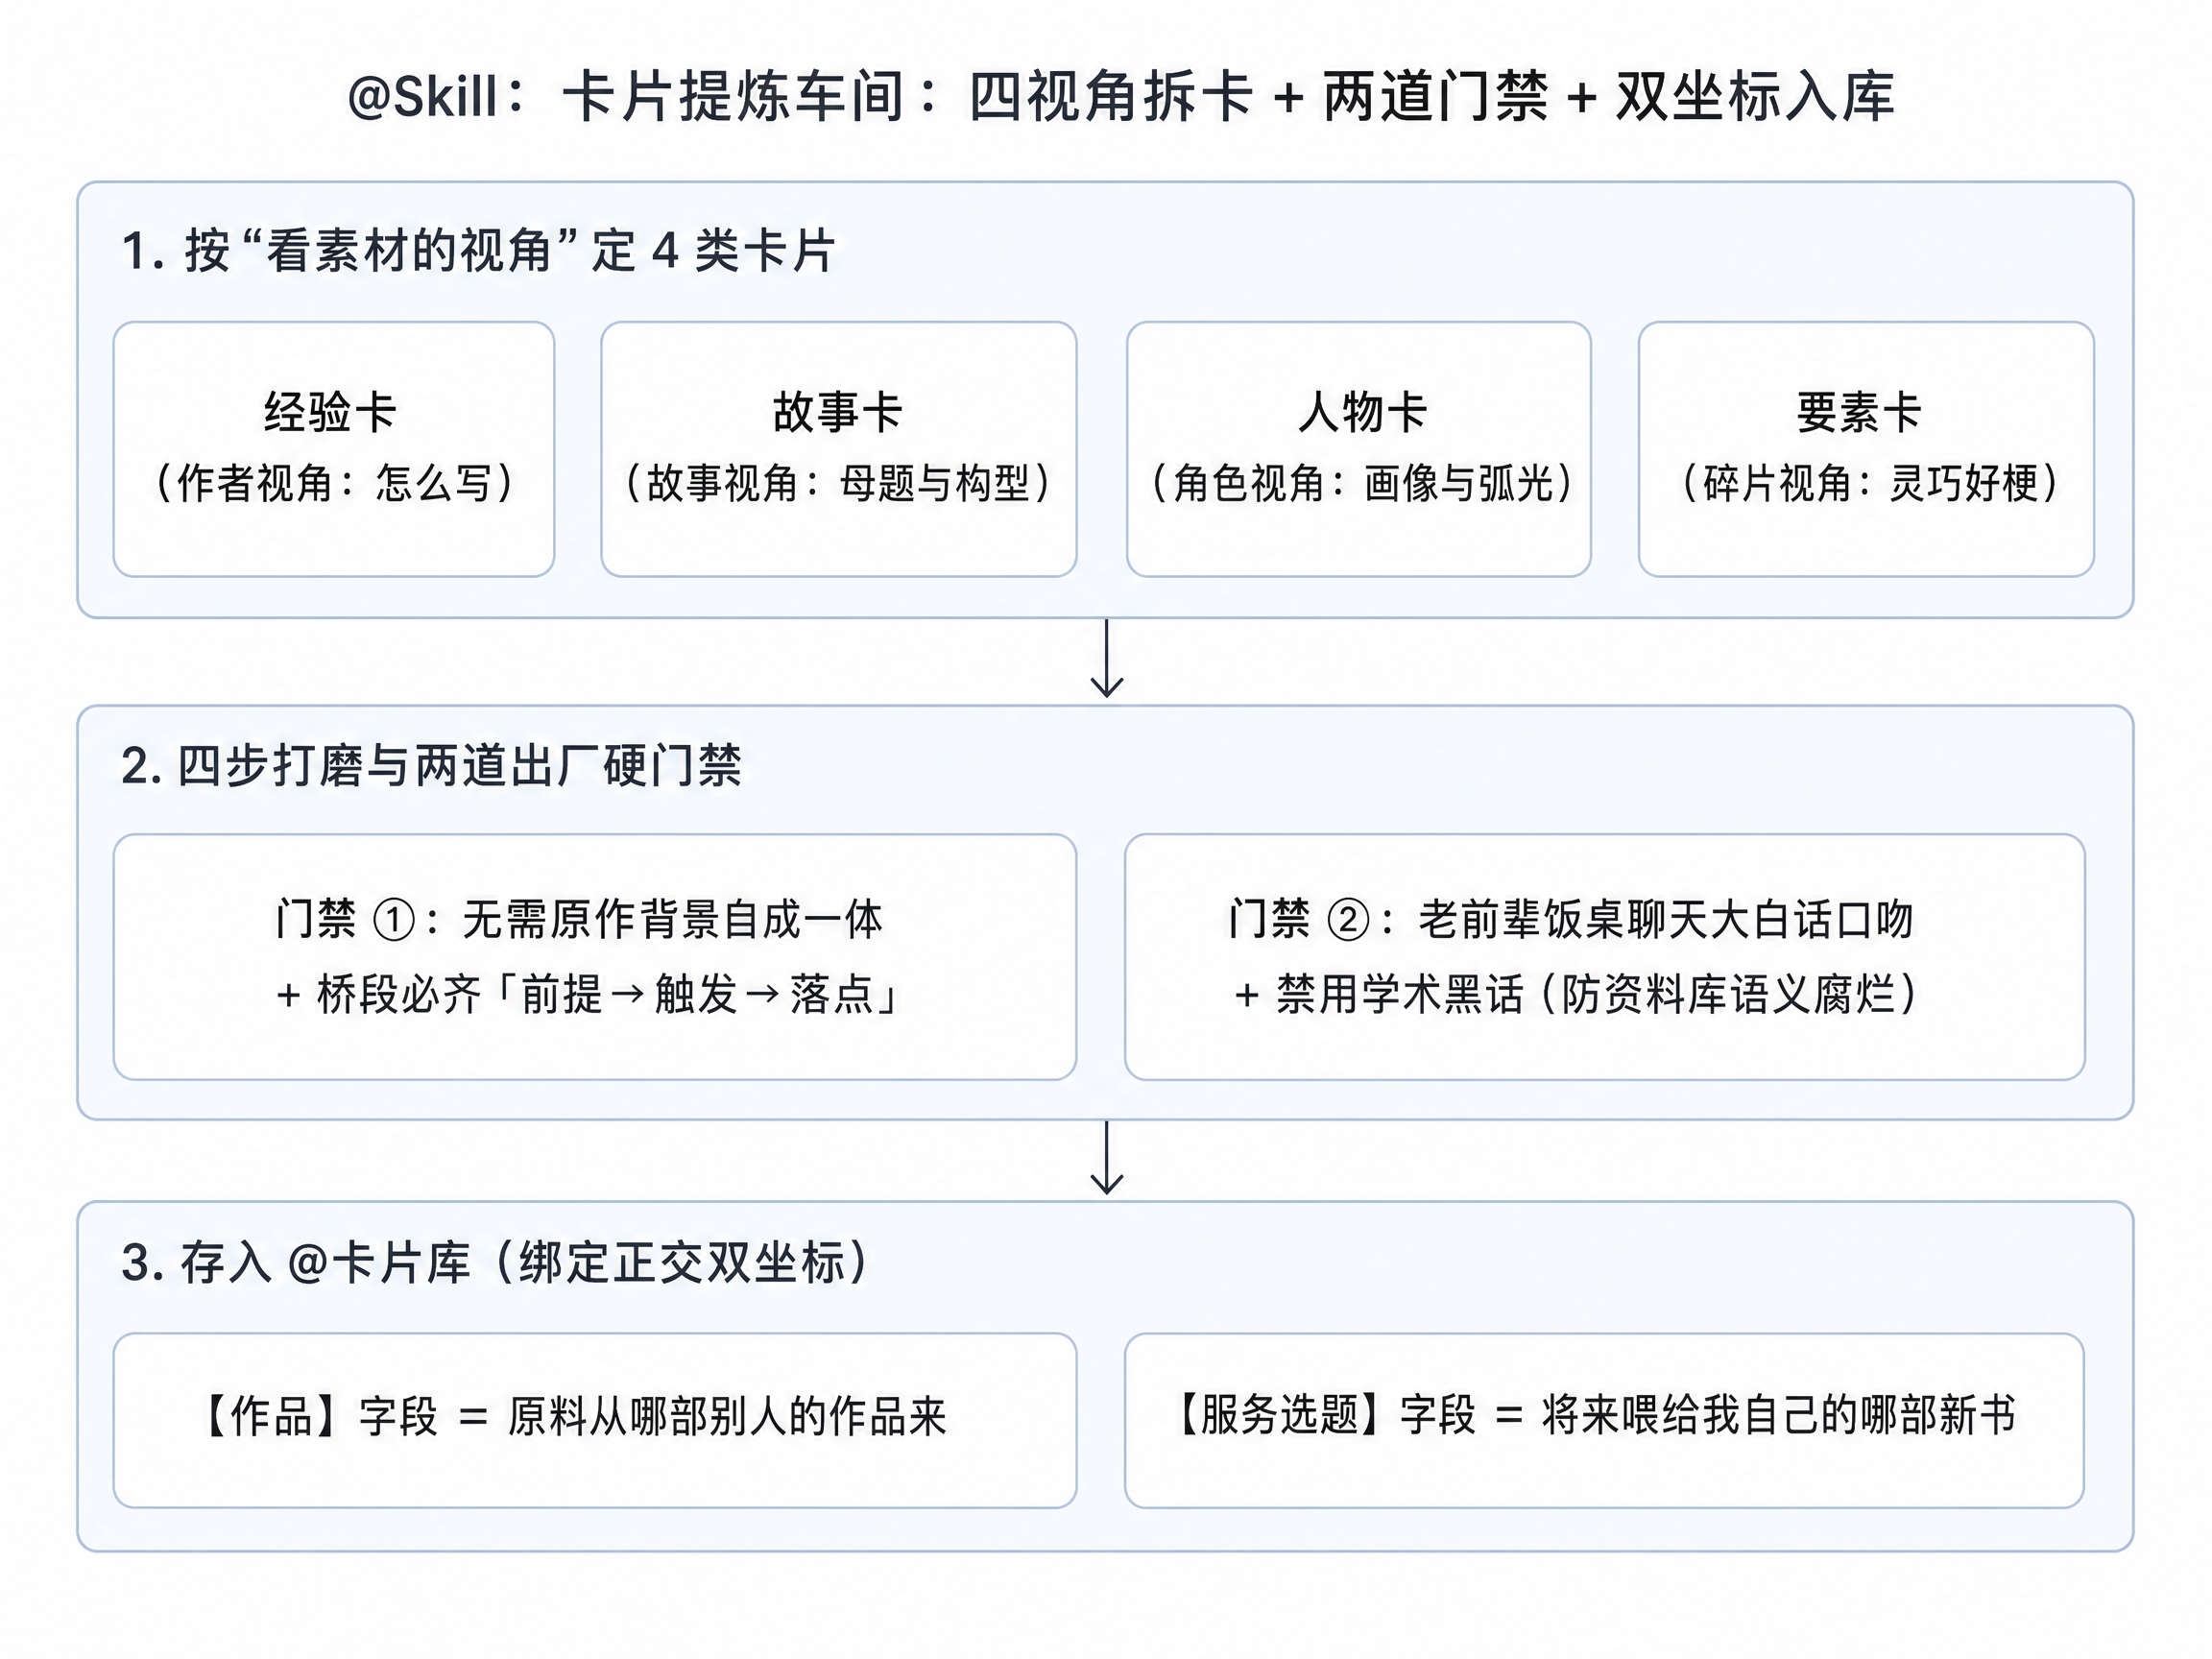
### 2. 进入 `@Skill:卡片提炼` 车间:按“视角”定卡型 + 两道硬门槛 + 双坐标入库
```mermaid mode=edit
flowchart TD
Step1["🔍 1. 按视角定 4 类卡:经验卡 / 故事卡 / 人物卡 / 要素卡"]
Step2["🌐 2. 四步打磨:讨论对齐 + 搜 TV Tropes 套路 + 补反面失效场景"]
Step3["🛡️ 3. 过两道硬门禁:无需原作自成一体 + 桥段必齐「前提·触发·落点」"]
Step4["📇 4. 存入 @卡片库:绑好「作品(出处)× 服务选题(去向)」双坐标"]
Step1 --> Step2 --> Step3 --> Step4
Agent 进入 @Skill:卡片提炼 页面后,我不用“玄幻、言情、悬疑”这种题材来分卡,而是规定按“看素材的视角”分成四类(同一个素材,从不同视角看可以拆出不同卡):
-
作者本位 → 经验卡:作者是怎么构思、怎么处理戏剧效果的(底下再分人物塑造、情节结构、情绪节奏、对话台词、宏观心法、选题框架、爽点循环 7 个子分类)。
-
故事本位 → 故事卡:故事本身的骨架和套路是什么(底下分跨文化的
母题 Motif和具体可复用的故事构型 Pattern)。 -
人物本位 → 人物卡:一个具体角色的立体画像、弧光和可移植亮点。
-
碎片视角 → 要素卡:不够撑起上面三类大卡、但扔掉又可惜的“梗儿和巧思”。
为了防止 AI 凑数产出废卡,页面里设了两道硬门槛:
-
卡片独立性铁律:所有卡片必须无需背景自成一体。如果一张卡必须先看过原小说才能读懂,说明没提炼到位,不准入库。
-
桥段三件套验收:凡是桥段型的故事卡,入库前必须写得出 ① 前提(事先埋下、角色自己还没真正检验过的东西)→ ② 触发(把前提推上台面的具体动作或事件)→ ③ 落点(认知、关系或局势发生不可逆的变化)。三段缺一段,就说明它还不是完整桥段,自动降级成“要素卡”或者退回素材池。
3. 四步加工法(带 TV Tropes 检索与反向探照灯)
在 @Skill:卡片提炼 页面里,我要求 AI 先跟我聊一轮确认提炼方向(除非我说“直接分发”),然后按四步走:
-
理解素材;
-
头脑风暴发散 5~8 个关键词方向 + 支线去搜
tvtropes.org(全球最大的故事套路百科):把发散出来的关键词翻成英文去 TV Tropes 查有没有对应的经典 Trope(套路词条),用公共叙事坐标来拓宽视野、校准判断; -
筛选定稿:一份素材最多只准出 1~2 张卡,宁少毋滥;
-
联网补充「相关扩展」与「另一方向」后入库:除了写清楚这招怎么用,还要求 AI 去搜“相反立场的写法、或者这招在什么场景下会失效”,写在卡片下半部分的
扩展视角里。
这么设计的好处: 每张卡片不仅把招式讲透了,还附带了 TV Tropes 的经典套路参照和“什么时候用这招会翻车”的反面提醒,参考价值比单纯摘抄一段话高得多。
4. 在卡片库里绑好「作品(出处)」与「服务选题(去向)」双坐标
卡片写进 @📇 卡片库 时,除了自动生成一个 6~8 位去掉易混淆字符(0/O/1/l/I)的唯一短码 card_id(比如 A7K2M9,哪怕手写在纸上或者口头念出来都很方便),最关键的是填好两个完全正交(互不干扰)的字段:
-
作品字段(管原料从哪来):只有当这张卡是从某部具体作品里拆出来的时候才填(格式:作品名(年份)· 具体位置),原创点子一律留空。 -
服务选题字段(管成品喂给谁):这是一个多选字段,填的是我自己正在写、或者计划要写的某部小说/某个题材方向。
这么设计的好处: 以前攒了上百张卡,真正开新书的时候根本想不起来去翻哪张。现在有了 服务选题 字段,每入库一张卡我就顺手给它挂上将来可能用得上的新书选题;等哪天真要动笔开这个坑了,直接在 Notion 数据库里用筛选器(Filter)按这个选题名一筛,平时攒下的相关人物卡、爽点循环卡、巧思梗就整整齐齐一包全端出来了。
五、 我是怎么写这些页面规则、怎么调教 Notion AI 的?
上面讲完了整个信息流转的架构,最后讲讲我在写《船板总指令》和这十几个 Skill 页面时,最看重的三个实操原则。
1. 我不调教AI写作,只管“说人话”尤其重点防止”语义腐败“
看到我在 Skill 页面里写口吻人设和反面案例,有人可能会误以为我是在用 Notion 搞自动化写作。恰恰相反,我在 Notion 里压根就没有建立专门的写作工作流。
关于真正的写作,我一直更信任针对每一篇具体文章或小说章节的“手搓”——所谓手搓,就是以自己动手写为主,以剪辑、组合为主,不过度信任 AI;真需要 AI 搭把手的时候,我更信任针对那一篇内容单写的针对性提示词,而不是指望靠一套固定模板去自动生成文章。
那我为什么还要在 Notion 的页面规则里大费周章地设置口吻模板和禁用词呢? 其实我的唯一目的,是为了让模型能够提炼、写出真正有参考价值的「经验卡」。
比方说,当你发过去一个电视剧片段或者一个好玩的段子,让 AI 帮你把里面的手法提炼出来时,这件事其实是最考验 AI 讲人话、讲母语能力的。 我试过一圈主流模型,你会发现很多模型,比如 Opus 4.8、GLM 5.3,还有以前的 GPT-5.x、Fable 5.1 这种……他们极其不擅长好好讲人话;而就算是在 K3 GLM 5.2 这种基础中文语料还行的模型上,你也必须对它进行强有力的引导,否则只要上下文一长,它立马就会给你提炼出一堆充满学术术语、生造黑话和悬浮抽象思维的所谓“思考”。那种东西拿回来根本没办法用。
很多时候,在文科的总结和提炼里,我们根本不是要让 AI 学会“写作”,而只是想让它老老实实地把一些基本的事儿讲明白。 在这个基础上,如果碰上一个讲话比较过关的模型(例如 Gemini 3.7),你就可以像我这样,在规则页里引导它去模仿“老前辈在饭桌上吹牛逼、或者老小说家在后台抽烟跟后辈传授手艺”那种很有“人味儿”、甚至带点乡土气的经验总结口气。对人类用户来说,这种大白话读起来才是最友好、最能一眼看懂的。
相反,那种提炼出高大上“抽象写作理论”的卡片是绝对不可取的。因为卡片库是一个长期积累、维护的池子,它是你的真正第二大脑,知识库核心,一定要保证「精神上的清洁卫生」!!
一旦放任这种抽象概念进库,等资料积累多了,后面再拿它们去参考、去组合时,就会不断叠加,变成“抽象x抽象”,抽象给抽象拜年了属于是。最终的结果就是,这笔记明明是你自己记的,但是你发现经过AI的手之后, 你完全无法理解它在说什么,你辛辛苦苦攒下来的整个资料库,彻底会因为“语义腐烂”而崩坏掉。
所以我在 @Skill:卡片提炼 页面里下了三道死规矩来防住语义腐烂:
- 给一个接地气的饭桌/后台聊天人设:
“全库通用口吻:像经验老道的小说家在后台抽烟时跟后辈聊的话(或者老前辈在饭桌上吹牛逼传授经验)——日常口语,有江湖味但逻辑成立,让人读完就想『这个我下次能用上』。多用口语化的转折和连词(『你看……就是因为……』『这招的妙处在于……』)。”
- 直接列出「反面禁用案例(死刑黑名单)」:
❌ 禁止写:「结构性悖反式的张力建构,在叙事母题的深层架构中扮演着不可替代的角色」 ❌ 禁止写:「三大支柱铸就长篇不崩之神话」 ❌ 禁止自造机制名词(「发动机」「归因链」「工程学」之类)——不许给一个梗起学名! ❌ 禁止「不是……而是……」式对偶八股,禁止把一句话就说得完的梗写成节拍表 / 结构解剖。
- 加上「交卷前自检」与老卡参照:
“正面基准:看库里我已经写好的那几张老卡,拿不准先去读一张老卡再动笔。交卷前自检:写完念一遍,凡出现自造术语、对偶八股、或者需要另做解释才读得懂的句子,一律改成大白话再入库。”
2. 数据库字段克制 并且严格区分开AI和用户记录的字段 防止冲突
建数据库的时候很容易犯贪多症,恨不得把难度评级、价值打分、来源作者、来源网址全拆成单独的字段。 我在交接规范里写了一条铁律:简单 + 可扩展,只要这两点起冲突,无条件选简单。永远不要因为“将来可能需要”而提前加字段、加状态机。
-
在
@📇 卡片库里,我把核心字段压到最简,连删除操作都不搞复杂流程,直接把status字段改成archived(归档封存)代替真删,保住card_id不丢。 -
更关键的是,对于像 PARA 里的
area(领域)这种我需要自己把握大局的字段,我直接在 Skill 页面的字段表格里写明:area:Agent 不填,由用户手动管理。明确告诉 AI 哪些格子不准它碰,省得它每次瞎猜乱填。
3. 日常调教必须靠长时间自己使用磨合打补丁 不可能一次性oneshot就尽善尽美
我这一整套指令页,根本不是第一天坐在电脑前憋出来的,而是大半年时间平时边用边聊,发现 AI 在哪儿犯傻,就当场在页面上打一行补丁做出来的。 举几个真实的补丁例子:
-
经验贴被拆碎的补丁:前面提过,有一次我把一篇完整的网文攻略丢给 AI 说“存起来”,它直接调用卡片提炼给我拆碎了。我当场就在总指令和卡片 Skill 顶部加了一个黄底高亮框(Callout):规定凡是完整经验贴,没看到“提炼卡片”四个字绝不准拆,只走网文知识库原样归档。
-
单张人设插画记录的补丁:有时候我随手传一张画得很好的角色插画,没有任何文字设定。AI 接手后懵了,不知道怎么按人物卡模板去写“人物弧光”。我就顺手在 Skill 里加了一小节《单图人设特殊路由》:只要识别到是单张人物角色图且没配严密文字设定,直接跳过卡片提炼,把图塞进另一个专门的
@人设[database]画廊库里完事。因为人设图本身也是很好的灵感来源, 而这不是AI能随便共鸣和提炼所谓经验的东西。 -
本地与云端 AI 防打架补丁:后来我本地电脑上的脚本和 Agent 也会往 Notion 里同步数据。为了防止云端 Notion AI 把我本地推上去的卡片给改了,我在规则页里加了一条:云端建的卡文末统一打上
processed_by: notion,凡是看到带着processed_by: local的页面,云端 AI 一律只读不改。
在 Notion 里调教 Skill 就是这么直接:页面就是规则本身,哪天聊着天发现它判断歪了,点开对应页面加一句“遇到 X 情况走 Y,不走 Z”,下一轮对话立刻生效。
六、 附:真实提示词模板示例 可以给你或者你家Agent 参考设计Notion 的skill page
📋 前台总路由页(Instruction Page)提示词示例
🚢 个人工作区 AI 总指令(公司前台 / 意图路由表)
定位:唯一的全局 Instruction Page。收到消息后,先查下表判断意图并分流,再动手干活。
§0 默认准则
你是我的通用办公与创作助手。不客套,不延伸,不主动议事。意图模糊时不乱猜,按默认对话处理。
§1 意图路由表(前台分流器)
意图类型 触发关键词 / 信号 分流去向(部门经理 / 目标仓库) 日程 / 待办 今天干啥、任务、日程、P0、提醒 → 转交 §2 日程模块(读写 @任务追踪与@日程日志)故事 / 提炼卡片 提炼、提一张卡、入卡、经验卡、故事套路、梗——内容脱离具体作品也成立 → 呼叫 @Skill:卡片提炼部门经理,加工后存入@📇 卡片库作品安利 / 待补 听说某作品好看、被安利、想补、别人推荐 → 记入 @⭐ 作品Wiki库并勾选外部安利字段(自动进安利看板)作品阅读笔记 已在看/看过的具体作品的观后感、追更吐槽、单集分析——离开该作品即不成立 → 写成 @⭐ 作品Wiki库对应作品条目下的平铺子页面(严禁混入卡片库!)原型收集 我想做一个XX工具/方案、记到收集区 → 呼叫 @Skill:原型收集部门经理,存入@原型收集区日常随手记 不含具体作品、非通用创作技法,且不属于以上任何分类 → 转交 §4 日常笔记规程:一字不改原样存入 @📓 Logs(状态标待分发)知识归档分发 明确要求「把 Logs 里的笔记归档分发」 → 呼叫 @Skill:知识分发路由部门经理,按 12 类知识地图投递至@📚 知识库⚡ 前台防误判铁律(核心筛选器)
「记一下」不是分类信号:它只表示“要记录”,具体去哪个仓库由上方内容实质决定,绝不因“记一下”三个字无脑塞进备忘录。
作品类三路互斥判别(按顺序过筛,先命中先分流):
① 还没看、别人推荐的 → 进
@⭐ 作品Wiki库(勾外部安利);② 在看/看过,内容离开这部作品就不成立 → 进
@⭐ 作品Wiki库对应条目的子页面(AI 只排版润色,绝不篡改观点);③ 从作品中抽出的通用招式,没看过原作的人也能直接拿去用 → 才进
@📇 卡片库。
📋 2:部门经理手册(Skill:卡片提炼)提示词示例
🔪 Skill:卡片提炼(故事创意部操作手册)
何时激活:用户明确说「提炼」「提一张卡」「入卡」,或提供素材要求入卡时读取本页。 ⚠️ 防误触拦截:若用户给的是完整经验长文/大佬攻略,且只说了「收藏、存起来、记一下」而未提「拆卡」,严禁拆碎,直接原样归档至
@📚 网文知识库!
一、 分类筛选器:视角决定类型(同一素材可从不同视角拆卡)
经验卡(作者视角):作者如何构思、设计、处理?指导「怎么写」(子分类:人物塑造 / 情节结构 / 情绪节奏 / 对话台词 / 宏观心法 / 选题框架 / 爽点循环)。
故事卡(故事视角):故事本身的框架与套路是什么?指导「写什么」(子分类:跨文化的
母题 Motif/ 可复用的故事构型 Pattern)。人物卡(角色视角):具体角色的魅力、弧光与可移植设定?指导「写谁」。
要素卡(碎片视角):「不够撑起整张卡,但扔掉太可惜」的灵巧设定与梗。
二、 出厂质检门禁(Quality Gate)
卡片独立性铁律:所有卡片必须无需背景自成一体。如果必须先看过原素材才能读懂这张卡,说明没有提炼到位,打回重写。
桥段三件套验收:桥段型故事卡入库前必须写得出 ① 前提(事先埋下未检验的事)→ ② 触发(推上台面的具体动作)→ ③ 落点(不可逆的局势/关系变化)。三者缺一即降级为「要素卡」。
先确认后入库:先与用户讨论一轮对齐提炼方向,确认后再动笔建页(除非用户下令「直接分发」)。
三、 写作口吻与反面黑名单(根治 AI 八股文)
全库统一口吻:像经验老道的小说家在后台抽烟时跟后辈聊的话——日常口语,有江湖味但逻辑严密,让人读完就想「这个我下次能用上」。多用口语转折(「你看……就是因为……」「这招的妙处在于……」)。
反面禁用黑名单(出现即重写):
❌ 禁用学术腔:「结构性悖反式的张力建构,在叙事母题中扮演着不可替代的角色」
❌ 禁用营销腔与排比升华:「三大支柱铸就长篇不崩之神话」
❌ 禁止自造机制学名:不许生造「情绪发动机」「归因链工程学」等词给一个梗起学名
❌ 禁止「不是……而是……」式对偶八股,一句话能说清的梗绝不列结构解剖表
四、 成品仓库字段契约(存入
@📇 卡片库)
card_id:生成 6–8 位大写字母+数字短码(去掉易混淆的0/O/1/l/I,如A7K2M9),方便手写与口述。
作品(原料出处) ×服务选题(成品去向):两者正交,严禁混填。作品仅在拆自某部具体作品时填写(原创留空);服务选题填写将来准备喂给自己的哪部新书或题材,供动笔前一键筛选调包。
这篇写完了之后,下一章我再介绍一下我这半年对沟槽的notion的mcp api体系的研究成果以及建立的后端优化设施,主要是讲一个事情:如果不购买AI,如果尽可能丝滑高效把notion的免费数据库当做云端数据库和文档上下文给外部的Agent使用。
也是突出一个废物利用吧。